I conservanti alimentari: istruzioni per l’uso

Spopolano, più o meno da quando esistono i social, video, post e altro sulla pericolosità dei conservanti alimentari. Ultimamente mi è capitato di vedere su Facebook il filmato di uno che pubblicizzava i suoi prodotti delineandone le qualità attraverso lo stigma dei conservanti: i suoi prodotti non contenevano conservanti; sottinteso: sono più buoni e salutari per questo motivo.

Ormai siamo talmente presi dalla chimica del senza (ne parlai tempo fa qui) che le aziende alimentari seguono questa moda. Al supermercato la dicitura “senza conservanti” compare ovunque: è stampata su confezioni di prosciutto, marmellate, sottaceti, taralli.

Ma rendiamoci conto di una cosa importante: sebbene sia di impatto per la pancia dei consumatori scrivere “senza conservanti”, questa locuzione non solo non dà alcuna informazione vera, ma non vuol dire assolutamente nulla. E sapete perché? Il sale del prosciutto è un conservante. Lo zucchero della marmellata è un conservante. L’aceto dei sottaceti è un conservante. Quella scritta significa soltanto che il produttore non ha aggiunto sostanze incluse nell’elenco degli additivi autorizzati, e non dice nulla su quali molecole stiano effettivamente impedendo all’alimento di marcire.

Da docente, in realtà, trovo questo equivoco alquanto istruttivo perché nasce da una convinzione precisa: che esista un confine netto tra ciò che la natura produce e ciò che l’industria sintetizza. Quel confine non esiste. Buona parte dei conservanti che leggiamo in etichetta sono molecole isolate per la prima volta da bacche, formaggi, batteri lattici. Alcune le mangiamo da millenni senza saperlo. La natura, del resto, produce molecole ben più aggressive di quelle che l’industria aggiunge: ne ho scritto a proposito del prezzemolo (qui) e della banana (qui).

PER CHI HA FRETTA

Cinque cose, senza chimica. Il resto dell’articolo spiega perché.

– «Senza conservanti» non vuol dire che nel cibo non c’è niente che lo conserva. Il sale del prosciutto, lo zucchero della marmellata e l’aceto dei sottaceti sono conservanti. Lo sono da sempre.

– La lettera E davanti a un numero non vuol dire «fatto in fabbrica». Vuol dire che quella sostanza è stata controllata, ha un permesso e una quantità massima da rispettare. E300, per esempio, è la vitamina C.

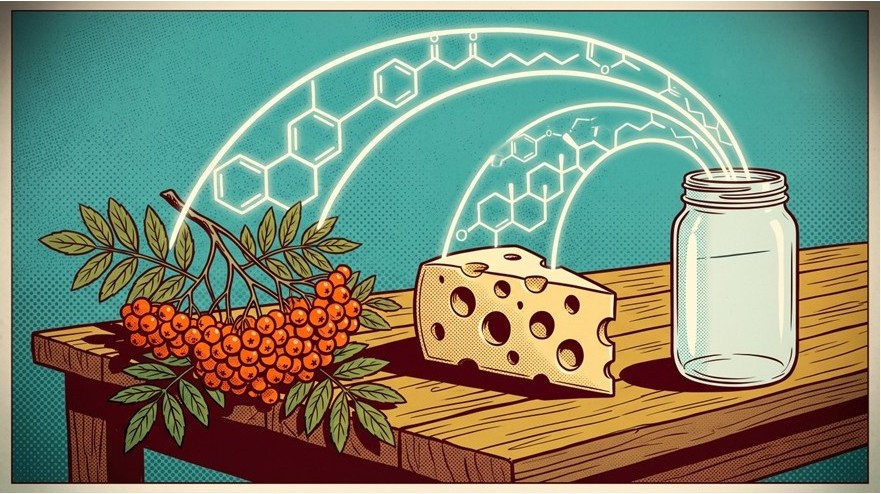
– Molti conservanti esistono già in natura. L’acido sorbico si trova nelle bacche del sorbo, l’acido benzoico nel mirtillo rosso, l’acido propionico nell’Emmental, dove lo fabbricano i batteri del formaggio. Sono le stesse identiche sostanze che leggiamo in etichetta.

– Le quantità permesse non sono decise a occhio. Si cerca la dose che negli animali non fa alcun danno, poi la si divide per cento. Quel numero, molto più piccolo, è quanto possiamo mangiarne ogni giorno per tutta la vita senza rischi. Se arrivano studi nuovi il limite si cambia: a volte si abbassa, a volte si alza.

– Il pericolo più grave che corriamo a tavola, in Italia, non viene dai barattoli del supermercato. Viene dalle conserve fatte in casa, proprio quelle senza conservanti aggiunti. Ogni anno una ventina o una trentina di persone si ammalano di botulismo, quasi sempre per un vasetto preparato in cucina.

Che cosa vuol dire conservare

Un alimento si degrada per quattro vie che vale la pena tenere distinte.

La prima è microbiologica: batteri, lieviti e muffe colonizzano il substrato e lo trasformano. La seconda è enzimatica: gli enzimi propri del tessuto continuano a lavorare dopo la raccolta o la macellazione, e producono imbrunimenti, rammollimenti, sapori estranei. La terza è ossidativa e riguarda soprattutto i lipidi insaturi, che per via radicalica generano idroperossidi e poi aldeidi volatili — l’odore del rancido. La quarta è fisica: migrazione d’acqua, cristallizzazioni, separazioni di fase.

Conservare significa rallentare tutte e quattro. Il modo più antico consiste nel togliere ai microrganismi l’acqua che serve loro. Non l’acqua totale: quella disponibile, misurata dall’attività dell’acqua aw, cioè dal rapporto tra la tensione di vapore dell’acqua nell’alimento e quella dell’acqua pura alla stessa temperatura.

L’ATTIVITA’ DELL’ACQUA IN PAROLE POVERE

Facendo delle semplificazioni notevoli, quando un soluto viene sciolto in acqua avvengono delle vere e proprie reazioni chimiche che vedono le molecole di acqua legarsi a quelle di soluto. Questo processo viene indicato col termine generico di solvatazione. Quando però a solvatare è l’acqua, si parla di idratazione.

In assenza di soluto tutte le molecole di acqua sono “libere”. Con questo termine voglio dire che esse interagiscono solo tra loro. Dalla definizione tecnica di attività dell’acqua – ovvero rapporto tra tensione di vapore dell’acqua in soluzione e quella dell’acqua “libera” – ne viene che aw di un bicchiere di acqua “libera” ha valore pari a 1. Quindi, quando diciamo aw=1, stiamo dicendo che non c’è alcun soluto disciolto. Il valore dell’attività può essere maggiore di 1? No! Il valore di aw è compreso solo tra 0 e 1.

Perché aw è sempre < 1?

Pensate che quando sciogliete un soluto nell’acqua, quest’ultima forma dei legami col soluto che, per quanto deboli, la trattengono in soluzione più fortemente di quanto possano fare i legami tra le molecole di acqua “libere”. Questo vuol dire che la sua tensione di vapore (PH2O) – cioè la pressione esercitata dal vapore sulla superficie del liquido da cui si stacca – è inferiore a quella dell’acqua pura (P0H2O).

Abbiamo detto che aw=PH2O/P0H2O. Quando il denominatore è più grande del numeratore il rapporto è sempre minore di 1.

Man mano che l’attività diminuisce possiamo semplicisticamente dire che un numero sempre maggiore di molecole di acqua si lega alle molecole di soluto che stanno aumentando progressivamente. In altre parole, l’attività dell’acqua diminuisce al crescere della concentrazione.

Sale e zucchero legano le molecole d’acqua in un guscio di solvatazione e abbassano aw. Sotto una certa soglia la crescita microbica si arresta. Per Clostridium botulinum (ovvero il batterio del botulino) quella soglia sta a 0,935: un salume stagionato sta ben al di sotto, un vasetto di melanzane sott’olio preparato in casa quasi sempre no. Del sale, e di come leggerne la quantità sull’etichetta nutrizionale, ho scritto qui.

L’acidificazione agisce su un altro fronte. E qui la chimica diventa interessante.

Acidi deboli, membrane e pH

Acido sorbico (E200), acido benzoico (E210), acido propionico (E280), acido acetico (E260), acido lattico (E270): la famiglia più numerosa dei conservanti è fatta di acidi carbossilici a catena corta. Il meccanismo è comune a tutti.

In soluzione l’acido esiste in equilibrio tra forma indissociata HA e anione A. Solo la forma indissociata, priva di carica, attraversa per diffusione passiva il doppio strato lipidico della membrana cellulare. Una volta dentro, dove il citoplasma ha pH prossimo alla neutralità, la molecola si dissocia e libera un protone. La cellula deve spendere ATP per espellerlo, l’anione si accumula, il pH interno scende, gli enzimi glicolitici perdono efficienza. Il microrganismo non muore: smette di moltiplicarsi. Sul significato del pH nei sistemi complessi, e su quanto le costanti acide dipendano da temperatura e forza ionica, ho scritto qui; sui sistemi tampone e sulle diete alcaline, invece, qui.

Il modello classico non spiega tutto. Per l’acido sorbico i dati sperimentali mostrano un’inibizione superiore a quella attribuibile alla sola acidificazione citoplasmatica: entrano in gioco il disaccoppiamento del potenziale di membrana e l’interferenza con la catena respiratoria. La lipofilia della molecola conta quanto la sua costante di dissociazione.

PERCHE’ IL pH DECIDE TUTTO

La frazione di acido presente in forma indissociata segue l’equazione di Henderson–Hasselbalch:

pH = pKa + log ([A]/[HA])

Acido benzoico, pKa 4,20: a pH 3,2 il 91% è indissociato e attivo, a pH 5,2 lo è appena il 9%.

Acido sorbico, pKa 4,76: a pH 6 resta attivo meno del 6% della molecola.

Aggiungere sorbato di potassio a un alimento neutro è un gesto quasi inutile. Questi conservanti funzionano nelle bibite, nelle salse, nei prodotti da forno acidificati – non ovunque.

Il sorbo, il mirtillo rosso e l’Emmental

L’acido sorbico prende il nome dal sorbo selvatico, Sorbus aucuparia. Nel 1859 August Wilhelm von Hofmann distillò un olio dalle bacche acerbe e ne isolò il costituente principale, l’acido parasorbico, che è il lattone dell’acido sorbico; il trattamento con alcali o acidi forti converte il lattone nell’acido isomero. Le bacche acerbe di sorbo contengono circa lo 0,1% di parasorbico. Le proprietà antimicrobiche furono riconosciute solo ottant’anni dopo, da Ernst Müller in Germania nel 1939 e da Chester Gooding negli Stati Uniti nel 1940. La pianta produceva un fungistatico per difendere i propri frutti; noi lo abbiamo copiato.

L’acido benzoico si comporta allo stesso modo. È presente in natura nel mirtillo rosso, nel cranberry, nel lampone artico e nella cannella. Nel mirtillo rosso la concentrazione di acido benzoico libero arriva a 0,6–1,3 g/L, con pH tra 2,6 e 2,9: la combinazione rende il succo praticamente infermentabile e capace di conservarsi senza alcuna aggiunta. Una marmellata di mirtilli rossi «senza conservanti» contiene più acido benzoico di molte bibite che lo dichiarano in etichetta.

L’acido propionico lo producono i batteri del genere Propionibacterium durante la maturazione dell’Emmental — la stessa fermentazione che genera l’anidride carbonica dei buchi. Chi mangia una fetta di Emmental sta ingerendo E280 di origine microbica. Il formaggio non riporta la sigla perché la molecola non è stata aggiunta: si è formata da sola.

Le sigle E

La E davanti al numero non identifica una sostanza artificiale. Indica che l’additivo ha superato la valutazione tossicologica europea ed è autorizzato con limiti d’uso definiti. È un numero di licenza, non un marchio d’origine.

Sotto quel codice si nascondono cose familiari. E300 è acido ascorbico, cioè vitamina C. E306–E309 sono tocoferoli, cioè vitamina E. E330 è acido citrico, il protagonista del ciclo di Krebs in ogni nostra cellula. E322 è lecitina, che nell’uovo e nella soia c’è di suo. E392 è estratto di rosmarino.

Di qualche sigla mi sono già occupato. E950 è l’acesulfame K (qui), e nella stessa serie ho trattato l’aspartame (qui) e la saccarina (qui).

Tra i conservanti veri e propri diversi sono di origine biologica dichiarata. La nisina (E234) è un peptide antimicrobico prodotto da Lactococcus lactis, lo stesso batterio dei latticini fermentati, e agisce legando il lipide II della parete batterica. La natamicina (E235) è un macrolide polienico ottenuto da Streptomyces natalensis, usato in superficie su formaggi e salumi contro le muffe. Il lisozima (E1105) si estrae dall’albume d’uovo ed è l’enzima che tutti noi produciamo nelle lacrime e nella saliva; nel Grana Padano serve a impedire il gonfiore tardivo da Clostridium tyrobutyricum.

Nessuna di queste molecole è più o meno «chimica» delle altre. Sono tutte chimica. E il problema della shelf life non riguarda solo gli alimenti: dei conservanti impiegati nei cosmetici ho scritto qui.

Come nasce un limite

Il criterio con cui si fissa una dose giornaliera ammissibile merita una spiegazione, perché è il punto in cui la percezione pubblica si allontana di più dal metodo. Un ragionamento dello stesso tipo l’ho già fatto discutendo il chlorpyrifos e la sua valutazione EFSA (qui); e vale per i farmaci quanto per gli additivi, come nel caso dell’aspirina (qui).

DAL NOAEL ALLA DGA

Si individua nella sperimentazione animale il livello più alto al quale non si osservano effetti avversi – il NOAEL – oppure, con approcci più moderni, il limite inferiore di confidenza della dose di riferimento, il BMDL.

Quel valore si divide per un fattore di incertezza, tipicamente 100: dieci per la possibile maggiore sensibilità della specie umana rispetto a quella animale, dieci per la variabilità tra individui.

Il risultato è la DGA: la quantità assumibile ogni giorno, per tutta la vita, senza rischio apprezzabile. Non è una soglia di tossicità. È una soglia di tossicità divisa per cento.

Il caso del sorbato mostra come il sistema si aggiorni. Nel 1996 il Comitato scientifico per l’alimentazione umana aveva fissato una DGA di gruppo di 25 mg/kg di peso corporeo al giorno. Nel 2015 l’EFSA, riesaminando i dati di tossicità riproduttiva, la abbassò in via provvisoria a 3 mg/kg applicando un fattore 100 a un NOAEL di 300 mg/kg. Nel 2019, sulla base di un nuovo studio riproduttivo esteso a una generazione, il gruppo di esperti ricavò un BMDL di 1.110 mg/kg e fissò la DGA definitiva a 11 mg/kg di peso corporeo al giorno. Un limite si è mosso due volte in quattro anni, in entrambe le direzioni, seguendo i dati.

I solfiti raccontano una storia meno rassicurante, e vale la pena raccontarla per intero. Nel 2016 l’EFSA confermò per anidride solforosa e solfiti (E220–E228) una DGA di gruppo di 0,7 mg di SO2 equivalenti per kg di peso corporeo, definendola però provvisoria a causa delle lacune del database, e concluse che le stime di esposizione superavano quel valore in tutti i gruppi di popolazione. Nel 2022, non essendo arrivati nuovi dati tossicologici, il gruppo di esperti giudicò la base scientifica inadeguata a derivare una DGA e la ritirò, passando all’approccio del margine di esposizione con un BMDL di 38 mg/kg — più basso del riferimento precedente di 70 — calcolato sull’allungamento della latenza dei potenziali evocati visivi.

Un’agenzia che ritira un limite invece di confermarlo non sta nascondendo nulla. Sta facendo il suo mestiere.

Nitriti: il caso complicato

Sui nitriti la discussione è legittima e non si risolve con una battuta.

Il nitrito di sodio (E250) in ambiente acido genera acido nitroso, che disproporziona liberando ossido di azoto. NO si coordina al ferro della mioglobina e forma nitrosilmioglobina; in cottura il complesso si converte in nitrosilemocromo, responsabile del colore rosa stabile dei salumi. La funzione antimicrobica passa per la stessa specie: NO attacca i cluster ferro-zolfo di enzimi essenziali dei clostridi, tra cui la piruvato-ferredossina ossidoreduttasi, e blocca il metabolismo energetico della cellula.

Il problema nasce altrove. Nitriti e ammine secondarie, in condizioni acide o ad alta temperatura, danno N-nitrosammine, alcune delle quali cancerogene. Per questo nelle miscele di salagione si aggiunge ascorbato di sodio (E301): l’ascorbato riduce l’agente nitrosante e sottrae il reagente alla reazione.

Nel 2015 la IARC ha classificato le carni lavorate nel Gruppo 1, cancerogene per l’uomo, sulla base di evidenza sufficiente per il tumore del colon-retto, stimando che 50 grammi al giorno aumentino del 18% il rischio relativo. Il dato va letto per quello che è: un aumento del rischio relativo su una base assoluta modesta, non un veleno. E la classificazione riguarda le carni lavorate nel loro insieme — anche affumicatura, cottura ad alta temperatura ed eme ferroso concorrono al meccanismo.

DA DOVE ARRIVANO DAVVERO NITRATI E NITRITI

Valutazione EFSA dell’esposizione, 2017:

– Gli additivi contribuiscono per meno del 5% all’assunzione totale di nitrato e per circa il 30% a quella di nitrito.

– Circa l’80% del nitrato che ingeriamo proviene dagli ortaggi; l’acqua potabile pesa attorno al 15%.

– Rucola, spinaci, bietole e sedano accumulano nitrato per fisiologia propria, tanto più quanto più la concimazione azotata è abbondante e la luce scarsa.

– Il regolamento europeo fissa per gli spinaci freschi un limite di 3.500 mg/kg.

L’EFSA ha stabilito per il gruppo E249–E250 una DGA di 0,07 mg per kg di peso corporeo, e il Regolamento (UE) 2023/2108 ha abbassato i tenori massimi impiegabili introducendo per la prima volta limiti residui calcolati su tutte le fonti presenti nel prodotto finito, con applicazione progressiva dal 9 ottobre 2025. La logica è la stessa dei tenori massimi fissati per l’acrilamide, di cui ho parlato qui. Ridurre, non abolire. Il motivo lo spiega il paragrafo che segue.

Il paradosso italiano

L’Italia è stabilmente tra i paesi europei con la più alta incidenza di botulismo alimentare. Dal 1986 al 30 settembre 2022 sono stati confermati in laboratorio 406 episodi, che hanno coinvolto 599 persone. La media è di 20–30 casi l’anno, nella grande maggioranza dovuti a conserve preparate in ambito domestico. L’errore più frequente nelle conserve sott’olio è un’acidificazione insufficiente; in quelle in acqua o salamoia, una quantità di sale troppo bassa. Le conserve vegetali sott’olio pesano per il 47,7% dei casi, quelle in acqua o salamoia per il 25,5%.

La tossina botulinica è tra le sostanze più tossiche conosciute e agisce su dosi dell’ordine dei nanogrammi. Le spore resistono a temperature elevate; la tossina, invece, si inattiva a 80 °C. Una conserva casalinga con pH superiore a 4,6, attività dell’acqua elevata e assenza di ossigeno sotto uno strato d’olio è un reattore progettato apposta per Clostridium botulinum. Di veleni naturali e delle dosi alle quali diventano letali ho scritto qui.

Il rischio microbiologico alimentare più grave che corriamo in questo paese arriva quindi da alimenti preparati esattamente come li chiede chi teme gli additivi: senza conservanti aggiunti, con ingredienti di provenienza nota, in casa. Non è un argomento contro le conserve domestiche, che si possono fare bene seguendo le linee guida dell’Istituto Superiore di Sanità. È un argomento contro l’idea che l’assenza di additivi coincida con la sicurezza.

Quello che leggo in etichetta

Un’etichetta che dichiara E202 mi dice che nel prodotto c’è sorbato di potassio entro un limite fissato, sotto una DGA calcolata su un BMDL diviso per cento. Un’etichetta che dichiara «senza conservanti» non mi dice niente: non so quanto sale, quanto zucchero, quale pH, quale trattamento termico, quale barriera all’ossigeno.

Preferisco la prima. Non perché l’additivo sia buono di per sé — un salume resta un alimento da consumare con misura, e su questo la IARC ha ragione — ma perché la sigla è un’informazione verificabile, mentre lo slogan è una rassicurazione.

Il sorbo produceva parasorbico prima che qualcuno lo distillasse. Il mirtillo rosso accumula acido benzoico da molto prima che noi sapessimo scrivere C6H5COOH. I batteri dell’Emmental producono acido propionico per conto loro. La differenza tra questi conservanti e quelli che compriamo in bustina non sta nella molecola, che è identica. Sta nel fatto che quelli in bustina li abbiamo misurati.

Bibliografia

Articoli su rivista

Bouvard V., Loomis D., Guyton K.Z., Grosse Y., El Ghissassi F., Benbrahim-Tallaa L., Guha N., Mattock H., Straif K., IARC Monograph Working Group (2015). Carcinogenicity of consumption of red and processed meat. The Lancet Oncology, 16(16), 1599–1600. https://doi.org/10.1016/S1470-2045(15)00444-1

Chan D.S.M., Lau R., Aune D., Vieira R., Greenwood D.C., Kampman E., Norat T. (2011). Red and processed meat and colorectal cancer incidence: meta-analysis of prospective studies. PLoS ONE, 6(6), e20456. https://doi.org/10.1371/journal.pone.0020456

Honikel K.-O. (2008). The use and control of nitrate and nitrite for the processing of meat products. Meat Science, 78(1–2), 68–76. https://doi.org/10.1016/j.meatsci.2007.05.030

Bernardo P., Patarata L., Lorenzo J.M., Fraqueza M.J. (2021). Nitrate is nitrate: the status quo of using nitrate through vegetable extracts in meat products. Foods, 10(12), 3019. https://doi.org/10.3390/foods10123019

Stratford M., Anslow P.A. (1998). Evidence that sorbic acid does not inhibit yeast as a classic ‘weak acid preservative’. Letters in Applied Microbiology, 27(4), 203–206. https://doi.org/10.1046/j.1472-765X.1998.00424.x

Ullah A., Orij R., Brul S., Smits G.J. (2012). Quantitative analysis of the modes of growth inhibition by weak organic acids in Saccharomyces cerevisiae. Applied and Environmental Microbiology, 78(23), 8377–8387. doi:10.1128/AEM.02126-12

Preparation of fermentable lingonberry juice through removal of benzoic acid by Saccharomyces cerevisiae yeast (2003). Food Research International, 36. doi:10.1016/S0963-9969(03)00007-3

Santamaria P. (2006). Nitrate in vegetables: toxicity, content, intake and EC regulation. Journal of the Science of Food and Agriculture, 86(1), 10–17. https://doi.org/10.1002/jsfa.2351

Colla G., Kim H.-J., Kyriacou M.C., Rouphael Y. (2018). Nitrate in fruits and vegetables. Scientia Horticulturae, 237, 221–238. https://doi.org/10.1016/j.scienta.2018.04.016

Pareri delle agenzie e normativa

EFSA ANS Panel (2015). Scientific opinion on the re-evaluation of sorbic acid (E 200), potassium sorbate (E 202) and calcium sorbate (E 203) as food additives. EFSA Journal, 13(6), 4144. doi:10.2903/j.efsa.2015.4144

EFSA FAF Panel (2019). Opinion on the follow-up of the re-evaluation of sorbic acid (E 200) and potassium sorbate (E 202) as food additives. EFSA Journal, 17(3), 5625. doi:10.2903/j.efsa.2019.5625

EFSA ANS Panel (2016). Scientific opinion on the re-evaluation of sulfur dioxide (E 220) … and potassium bisulfite (E 228) as food additives. EFSA Journal, 14(4), 4438. doi:10.2903/j.efsa.2016.4438

EFSA FAF Panel (2022). Follow-up of the re-evaluation of sulfur dioxide–sulfites (E 220–228). EFSA Journal, 20(11), 7594. doi:10.2903/j.efsa.2022.7594

EFSA (2017). Nitriti e nitrati aggiunti agli alimenti — sintesi dei pareri scientifici, giugno 2017. efsa.europa.eu

EFSA CONTAM Panel (2008). Nitrate in vegetables. EFSA Journal, 689, 1–79. https://efsa.onlinelibrary.wiley.com/doi/pdf/10.2903/j.efsa.2008.689

Regolamento (UE) 2023/2108 della Commissione, che modifica i regolamenti (CE) 1333/2008 e (UE) 231/2012 per quanto riguarda i nitriti (E 249-250) e i nitrati (E 251-252). https://eur-lex.europa.eu/eli/reg/2023/2108

Istituto Superiore di Sanità — Centro Nazionale di Riferimento per il Botulismo (2016). Linee guida per la corretta preparazione delle conserve alimentari in ambito domestico. iss.it

ISS — EpiCentro. Botulismo alimentare: aspetti epidemiologici in Italia. epicentro.iss.it
Vaccini: fatti, non opinioni!

Chi mi legge da tempo sa che sono un chimico, con una formazione di base in chimica organica e una specializzazione successiva in chimica fisica dei suoli. Non sono un medico, tanto meno un virologo, ma la mia formazione professionale mi permette di leggere e comprendere la letteratura scientifica in senso lato. Per questo, in passato, sono intervenuto più volte a favore delle vaccinazioni.

Anche stavolta sento il bisogno di intervenire in un ambito che non è il mio, ma che resta parte della formazione di un chimico, pur con un grado di specializzazione ben inferiore a quello di un medico. Un recente caso di difterite è costato la vita a una bambina di quattro anni a Palermo — nel momento in cui scrivo, la diagnosi è ancora sotto verifica ufficiale. Questo mi spinge a tornare su un tema che ho già affrontato: in queste ore, sui social, l’evento è stato utilizzato da alcuni per rilanciare teorie che la scienza ha da tempo smontato. Non scrivo per alimentare una polemica, ma per mettere a disposizione i dati che conosco. Su come si cura la difterite, e perché la diagnosi tempestiva sia così determinante (si veda il box alla fine dell’articolo).

Veniamo dunque ai fatti. Come sono nate le vaccinazioni? Quante malattie hanno permesso di debellare? È vero che, anche grazie ai vaccini, la durata media della vita umana si è allungata?

Andiamo nei dettagli.

Origine ed evoluzione tecnologica delle piattaforme vaccinali

L’immunizzazione attiva affonda le radici nelle pratiche empiriche di variolizzazione documentate in Asia. La formalizzazione scientifica risale invece al 1796, anno in cui Edward Jenner impiegò il vaiolo bovino (cowpox) per indurre una risposta immunitaria crociata e protettiva contro il vaiolo umano (smallpox).

Louis Pasteur, nel tardo Ottocento, estese il principio ad antrace e rabbia, introducendo l’attenuazione – il microrganismo viene coltivato in condizioni subletali o su ospiti eterologhi per sopprimerne la virulenza preservandone l’immunogenicità.

Il Novecento e i primi decenni del Duemila hanno introdotto piattaforme diversificate:

  • Vaccini inattivati (uccisi): il patogeno viene reso non replicante tramite calore o agenti chimici come la formaldeide (es. antipolio Salk).
  • Tossoidi (anatossine): tossine batteriche modificate chimicamente; perdono la tossicità diretta ma stimolano anticorpi neutralizzanti (es. tetano e difterite).
  • Vaccini a subunità e coniugati: frammenti proteici o polisaccaridi capsulari specifici, legati a proteine carrier per indurre memoria immunologica T-dipendente (es. Haemophilus influenzae b, Epatite B).
  • Piattaforme a mRNA: sequenze nucleotidiche incapsulate in nanoparticelle lipidiche (LNP) che istruiscono i ribosomi dell’ospite a produrre transitoriamente l’antigene bersaglio. L’mRNA non penetra nel nucleo, non interagisce con il genoma e viene rapidamente degradato dagli enzimi cellulari.

Profilo di rischio relativo ed eventi avversi

Nessun presidio farmacologico presenta rischio nullo. L’analisi epidemiologica valuta il rapporto rischio/beneficio confrontando l’incidenza delle complicanze dell’infezione naturale con quella delle reazioni avverse post-vaccinali. È umano avere timore di un ago o di una sostanza “estranea” che viene iniettata nel corpo: la paura è un’emozione legittima. Ma la scienza ci chiede di trasformare quella paura in una domanda precisa: cosa succede se non mi vaccino? I numeri che seguono rispondono a questa domanda.

  • Difterite da infezione naturale: tasso di letalità compreso tra il 5% e il 10% (superiore al 20% nei bambini sotto i 5 anni), causato da ostruzione meccanica delle vie aeree, miocardite tossica e paralisi periferiche.
  • Vaccinazione antidifterica: reazioni locali e febbre transitoria nella maggioranza dei casi; reazioni anafilattiche gravi stimate nell’ordine di 1 caso per milione di dosi.
  • Morbillo da infezione naturale: polmonite in 1 caso su 20, encefalite acuta in 1 su 1.000, panencefalite sclerosante subacuta letale in 1 su 10.000–100.000, letalità globale di 1–2 casi su 1.000.
  • Vaccinazione MPR: febbre ed esantema transitori nel 5–15% dei casi, trombocitopenia transitoria in 1 su 30.000 dosi, anafilassi in circa 1 caso su milione.

La sicurezza viene verificata in modo costante tramite i sistemi internazionali di farmacovigilanza attiva e passiva, come VAERS ed EudraVigilance. Ogni segnale di dubbio viene indagato; ogni evento avverso serio viene registrato e studiato. È così che sappiamo, con precisione, qual è il profilo di rischio reale di ogni vaccino.

Dinamica dell’immunità di gregge

L’immunità di popolazione interrompe la trasmissione orizzontale del patogeno, proteggendo i soggetti non vaccinabili per gravi controindicazioni cliniche o età neonatale. La frazione critica di popolazione da immunizzare (Ic) si calcola a partire dal numero di riproduzione di base (R0), secondo la relazione:

Ic = 1 – (1 / R0)

Tradotto in parole: se un malato di morbillo ne contagia in media 15 (R0=15), per fermare il virus serve che almeno 93 persone su 100 siano immuni. Se scendiamo all’85%, il virus trova ancora terreno fertile. Per patogeni a elevatissima trasmissibilità per via aerea, come il morbillo (R0 tra 12 e 18) o la difterite (R0 tra 4 e 7), la copertura vaccinale richiesta si colloca tra l’85% e il 95%. Sotto questi valori, l’accumulo di individui suscettibili innesca catene di contagio e focolai epidemici.

La non correlazione tra vaccinazioni e autismo

L’ipotesi di un nesso di causalità tra il vaccino MPR e i disturbi dello spettro autistico deriva da uno studio del 1998 firmato da Andrew Wakefield su The Lancet, condotto su un campione di appena 12 soggetti.

Le successive verifiche giudiziarie ed etiche hanno documentato la deliberata falsificazione dei quadri clinici e la presenza di conflitti di interesse economici taciuti, tra cui accordi legali e brevetti depositati per vaccini concorrenti. Nel 2010 The Lancet ha ritirato l’articolo per frode scientifica, e il General Medical Council ha radiato Wakefield dall’albo dei medici.

Studi epidemiologici su larga scala hanno confutato l’associazione. Lo studio di coorte danese su 537.303 soggetti (Madsen et al., 2002) ha rilevato un rischio relativo non significativo tra vaccinati e non vaccinati (RR = 0.92, intervallo di confidenza al 95%: 0.68–1.24). La successiva coorte di 657.461 bambini, seguiti per oltre 5 milioni di persone-anno (Hviid et al., 2019), ha confermato l’assenza di correlazione anche nei sottogruppi con fattori di rischio ereditari o ambientali (Hazard Ratio = 0.93, intervallo di confidenza al 95%: 0.85–1.02).

Conclusioni

I numeri, da soli, non convincono chi ha già deciso di non farsi convincere. Chi rifiuta un vaccino raramente lo fa per ignoranza dei dati: più spesso li ignora, i dati, o li nega comunque, indipendentemente da quanto siano solidi. Per questo non scrivo queste righe per chi ha già scelto di credere a un medico radiato dall’albo piuttosto che a due coorti di centinaia di migliaia di bambini ciascuna.

Le scrivo per chi sta ancora leggendo con la mente aperta, magari incuriosito da un titolo di giornale o da un post condiviso da un conoscente. A questa persona dico una cosa sola, da chimico e non da medico: la scienza che sostiene le vaccinazioni non è un’opinione tra le tante. È il risultato di due secoli di osservazioni, verifiche e smentite reciproche – lo stesso metodo che ha permesso di smascherare un caso di frode come quello di Wakefield e di ritirarne il lavoro dalla letteratura scientifica.

Una bambina di quattro anni è morta a Palermo per quella che i medici, in attesa della conferma di laboratorio, ritengono difterite, una malattia contro cui esiste un vaccino con un rischio di reazione grave stimato in un caso su un milione di dosi. Sui social, in queste ore, alcuni commenti equiparano il vaccino a un’opinione. Non lo è. È un dato. Quando qualcuno, sapendo perfettamente che il tasso di mortalità per difterite è centinaia di migliaia di volte superiore al rischio di una reazione grave, scrive che “è meglio il rischio della malattia”, non sta esprimendo un’opinione: sta scrivendo una falsità. E quando questa falsità viene diffusa mentre una bambina è ancora in ospedale o subito dopo il suo decesso, non è più disinformazione: è sciacallaggio. Per questo non trovo spazio per l’equidistanza, e non credo dovrebbe trovarlo nessuno che abbia letto fin qui.

Box – Come si cura la difterite

Gli antibiotici sono parte necessaria della terapia, ma non sono la cura. Il loro compito è eliminare il Corynebacterium diphtheriae dall’organismo, fermarne la diffusione e prevenire il contagio: agiscono sul batterio, non sulla tossina che questo ha già rilasciato in circolo. È la tossina, non l’infezione in sé, a danneggiare cuore e nervi in modo spesso irreversibile.

Per questo la terapia antibiotica va sempre associata all’antitossina difterica, che neutralizza la tossina circolante prima che si leghi ai tessuti. Una volta legata, l’antitossina non ha più effetto: la finestra utile è stretta, e la rapidità della diagnosi conta quanto la disponibilità del farmaco.

Le opzioni antibiotiche raccomandate da CDC e OMS sono due: i macrolidi (eritromicina, azitromicina) e la penicillina (G o procaina). La scelta tra le due dipende anche dai pattern di resistenza locali – negli ultimi anni sono stati segnalati, in diverse aree del mondo, tassi crescenti di resistenza alla penicillina, motivo per cui un antibiogramma resta buona pratica prima di impostare la terapia. Il trattamento dura in genere 14 giorni per la forma respiratoria, 10 per quella cutanea, che in casi meno gravi e senza segni di tossicità sistemica può essere gestita con antibiotico e disinfezione topica della lesione, senza necessità di antitossina.

Tutto questo vale quando la malattia viene riconosciuta in tempo. Ma è proprio questo il punto debole del sistema: la difterite è oggi così rara che pochi medici, nella pratica clinica quotidiana, l’hanno mai vista. Un ritardo diagnostico di uno o due giorni può bastare a rendere inefficace anche la terapia più corretta, perché la tossina, una volta legata ai tessuti, non è più reversibile. Ecco perché la prevenzione resta l’unica strategia che non dipende dalla rapidità di una diagnosi difficile: un patogeno che non entra in circolo non ha tossina da neutralizzare.

Per saperne di più

Il Paradosso del Condizionatore

Siamo ormai nella seconda metà di agosto e, come ogni anno, il caldo si sente, ed è anche abbastanza torrido. Qui a Palermo, poi, non ne parliamo proprio. Certo, quest’anno sta andando meglio rispetto a qualche anno fa, quando la città fu circondata da un muro di fuoco dovuto agli incendi dei boschi circostanti, e il termometro sul mio balcone esposto al sole arrivò a segnare ben 52 °C, con un’umidità scesa intorno al 2%. Morirono insetti e piante. Per qualche giorno sembrò di vivere in un mondo alieno.

In quelle circostanze i condizionatori furono un vero e proprio toccasana, come del resto lo sono anche oggi, perché ci aiutano a resistere alla calura da bollino rosso. Ma, esattamente come ogni estate calda, l’uso continuo dei condizionatori da parte di chi rimane in città ha delle conseguenze: ci sono picchi di consumo elettrico che di tanto in tanto provocano un blackout, da qualche minuto a qualche ora – col caldo interno delle case che aumenta proprio per lo spegnimento dei condizionatori – e i costi economici per le tasche degli utenti che volano alle stelle.

Ma sono solo questi gli svantaggi dell’uso dei condizionatori? In realtà no. E sapete perché? Perché i condizionatori, come tutte le attività antropiche, hanno un’impronta ecologica non banale.

Con l’aiuto di un’AI ho ipotizzato uno scenario e fatto dei calcoli per capire quanto possano impattare i condizionatori a livello di cambiamento climatico globale.

Cominciamo e proviamo a fare due conti, dalla scala di quartiere a quella globale.

Il bilancio termico su scala urbana: una cittadina di 10.000 abitanti

Consideriamo una cittadina di 10.000 abitanti, con una media di 3 persone per famiglia (circa 3.330 case) e due climatizzatori per abitazione. Durante un’ondata di calore, se metà delle unità installate resta accesa per 12 ore al giorno, si ottengono circa 3.300 split in funzione simultanea.

Un condizionatore residenziale standard non genera freddo dal nulla: sottrae calore dall’interno (2,5 kW termici) e lo scarica all’esterno, sommando a quel calore l’energia elettrica consumata dal compressore (circa 0,78 kW per un’unità efficiente). Il calore totale scaricato per macchina è quindi di circa 3,28 kW.

Moltiplicato per 3.300 unità, il calore immesso nell’aria urbana sale a circa 11 MW. Distribuita su un’area urbanizzata tipica di 1,5 km², questa potenza corrisponde a una densità termica antropica di circa 7,3 W/m².

Il paragone con l’irraggiamento solare estivo, che supera facilmente gli 800 W/m², ridimensiona il fenomeno: di giorno il solo rigetto termico degli impianti produce un incremento reale della temperatura dell’aria compreso tra +0,3 °C e +0,5 °C. I salti più marcati, tra +1,5 °C e +2 °C, si registrano quasi solo di notte, quando lo strato limite atmosferico si abbassa, o dentro vicoli stretti e cortili chiusi – i cosiddetti street canyon.

Dalla termodinamica locale al clima globale: la vera trappola

Se a livello locale il calore diretto dei condizionatori scalda l’aria di frazioni di grado, quale peso ha sul clima globale?

L’effetto termico diretto resta trascurabile. Il calore puro espulso da tutti gli impianti del mondo pesa per una quota infinitesimale, meno dello 0,015%, sul bilancio energetico radiativo terrestre. Non è l’aria calda in uscita dal motore a scaldare il pianeta.

L’effetto indiretto è quello che conta davvero. La climatizzazione assorbe quasi un quinto dell’elettricità consumata dagli edifici nel mondo, pari a circa il 10% dell’elettricità globale, ed è responsabile di una quota compresa tra il 7% e il 10% delle emissioni totali di gas serra legate al settore del raffreddamento, a cui si aggiunge il potenziale climalterante delle perdite di gas refrigeranti (HFC).

Le proiezioni più citate stimano che la sola diffusione dei climatizzatori aggiungerà tra +0,03 °C e +0,07 °C alla temperatura media del pianeta entro il 2050.

Conclusioni

In definitiva, come al solito, si realizza uno scenario che potremmo definire “il cane che si morde la coda”. Più aumenta la temperatura al suolo per effetto delle varie attività antropiche, più aumenta la necessità di refrigerio all’interno delle abitazioni e dei luoghi di lavoro. Ma più aumenta questa necessità, più aumenta l’emissione di gas serra che, a loro volta, porta all’ulteriore incremento della temperatura globale.

Non so se riuscite a vedere il paradosso della climatizzazione. Lo trovo affascinante ma, allo stesso tempo, terribile. La nostra esigenza di sopravvivere a temperature sempre più elevate ci porta ad aumentare quelle stesse temperature alle quali non riusciamo a sopravvivere. Cosa accadrà? Esistono soluzioni? Onestamente non lo so.

Ripensando a quanto accaduto durante la pandemia del 2020, quando ci sono stati milioni di morti a livello globale e sono sopravvissuti soprattutto i più adatti a vivere in quelle condizioni, immagino che accadrà lo stesso. L’aumento delle temperature, al quale sembra non ci sia molto rimedio, comporterà la selezione di quella fetta di popolazione maggiormente adatta a vivere nelle condizioni sempre più torride che si prospettano. Alla fine possiamo dire che Darwin aveva ragione, e che ha avuto la vista molto lunga.

Per approfondire

Sospeso nel nulla: la chimica di un corpo nello spazio

Non me ne vogliano i tanti fisici che mi leggono. Lo so che il titolo di questo articolo contiene un errore da un punto di vista fisico. Lo spazio che ci circonda – o, meglio, lo spazio che circonda la Terra – non è “nulla”. Nello spazio – anche quello più profondo – c’è sempre “qualcosa”: radiazione, particelle rade, campi e così via di seguito. Ma il “nulla” a cui faccio riferimento evòca il mio senso di smarrimento quando con la fantasia mi spingo nelle navicelle spaziali ed immagino una passeggiata cosmica lontano da tutto e da tutti, solo con me stesso e con le mie paure.

L’ultimo viaggio senza ritorno

Al di là delle mie fantasie notturne, la domanda ha oggi una rilevanza concreta:  viviamo in un’era in cui l’idea di morire nello spazio ha smesso di essere un’esclusiva della fantascienza. Tra missioni lunari, futuri viaggi verso Marte e l’orizzonte delle stelle, la presenza umana oltre l’atmosfera è ormai una realtà.

Ma cosa accadrebbe se un corpo umano venisse accidentalmente esposto al vuoto cosmico, senza tuta e senza navicella?

La risposta della chimica e della fisica vi sorprenderà, soprattutto se siete abituati ai cliché di Hollywood: niente esplosioni spettacolari, niente sangue che gela in un millisecondo. E, soprattutto, niente decomposizione. Per capire il perché, dobbiamo fare un piccolo passo indietro e ricordare come funziona la putrefazione qui sulla Terra.

I tre ingredienti della putrefazione (che nello spazio non esistono)

Sulla Terra, un corpo abbandonato segue un copione biologico e chimico molto preciso, guidato da fattori specifici:

  • I batteri aerobi: Hanno bisogno di ossigeno e iniziano immediatamente a consumare i tessuti superficiali.
  • I batteri anaerobi: Vivono nel nostro intestino e prendono il sopravvento non appena finisce l’ossigeno, producendo i classici gas maleodoranti.
  • L’acqua liquida: È il solvente universale, il mezzo essenziale che permette a questi microrganismi di muoversi, nutrirsi e moltiplicarsi.
  • Il calore: Una temperatura compresa tra 0 e 40°C agisce da catalizzatore, accelerando tutte le reazioni enzimatiche e biologiche.

Nel vuoto dello spazio, questo “kit biologico” viene completamente azzerato:

  • Ossigeno: non c’è.
  • Acqua liquida: Impossibile da mantenere; bolle all’istante o sublima, passando direttamente da solida a vapore.
  • Temperatura: Estrema e schizofrenica. Si passa da un calore torrido (+120°C se esposti direttamente al Sole) al gelo cosmico (-270°C all’ombra).
  • Pressione: Assente. In orbita terrestre il vuoto è già milioni di volte più rarefatto dell’atmosfera al suolo; nello spazio interstellare profondo la rarefazione arriva a livelli miliardi di volte superiori a quelli ottenibili nel miglior vuoto di laboratorio.

Il risultato? La decomposizione non ha nemmeno il tempo di iniziare: i batteri muoiono o entrano in uno stato di totale quiescenza.

Cronaca di un corpo nel vuoto: i primi minuti

Immaginiamo la scena: un corpo viene espulso da un’airlock senza alcuna protezione. Cosa succede timeline alla mano?

Da 0 a 15 secondi: La mancanza di pressione impedisce ai polmoni di scambiare gas, portando alla perdita di coscienza per mancanza di ossigeno al cervello in pochi secondi. Il decesso, però, non è istantaneo: se non si ripristina la pressione, sopraggiunge entro uno o due minuti.

Da 10 a 30 secondi: Qui la fisica si fa strana. Poiché la pressione è zero, l’acqua presente sulla superficie degli occhi, della bocca e nei polmoni inizia a bollire a temperatura corporea (sì, a pressione zero l’acqua bolle a 37°C!). Tuttavia, la pelle è estremamente elastica e resistente: il corpo non esplode. Si gonfia fino a raddoppiare il suo volume (un fenomeno noto come ebollizione dei fluidi tissutali).

Dopo qualche ora: Il congelamento non è istantaneo. Nel vuoto non c’è aria per rimuovere calore (manca la convezione) e non c’è contatto con superfici fredde (manca la conduzione). L’unico modo in cui il corpo può cedere calore è per irraggiamento, un processo molto lento. Ci vorranno diverse ore prima che inizi a ghiacciare, con la parte esposta al Sole letteralmente bruciata e quella all’ombra congelata.

Dopo giorni o settimane: Tutta l’acqua residua nei tessuti sublima lentamente verso il vuoto. Il corpo si trasforma in una mummia spaziale: secco, duro come il cuoio e completamente sterile.

La chimica del “silenzio biologico”

Niente vermi, niente produzione di gas, nessuna putrefazione. In termini scientifici, non parliamo di decomposizione ma di mummificazione o, ancora meglio, di liofilizzazione, l’esatto equivalente industriale del processo che usiamo per il caffè solubile o per preservare i vaccini.

Senza acqua a disposizione, i batteri intestinali si disidratano, morendo o rintanandosi sotto forma di spore resistenti (una sorta di ibernazione). I funghi e i lieviti non trovano un briciolo di umidità per sopravvivere. Persino gli enzimi autolitici, quelli che normalmente darebbero il via all’autodigestione cellulare subito dopo la morte, restano letteralmente a secco e si bloccano. Il corpo resta così intatto e riconoscibile, simile a una statua di cera essiccata.

Gli unici veri agenti di degradazione nello spazio non sono biologici, ma fisici:

Micrometeoriti: Piccolissimi frammenti che si comportano come un abrasivo cosmico, erodendo la superficie del corpo millimetro dopo millimetro.

Radiazioni UV: Se il corpo si trova vicino a una stella, i raggi ultravioletti spezzano i legami delle molecole organiche, riducendo la pelle a un residuo carbonioso. Diventa a tutti gli effetti un cadavere tostato e liofilizzato.

Radiazioni ionizzanti: I raggi cosmici distruggono i filamenti di DNA e le proteine ma, anziché far marcire il corpo, lo sterilizzano ulteriormente.

Due destini opposti: Dove sta viaggiando il corpo?

Il destino finale della nostra mummia cosmica dipende tutto dalla sua posizione nella mappa galattica:

Condizione ambientale Vicino a una stella (es. Orbita terrestre) Spazio interstellare profondo
Temperatura Altalenante: da -100°C a +120°C a seconda dell’esposizione Costante a -270°C (appena sopra lo zero assoluto)
Effetto principale Radiazioni UV distruttive + continui shock termici Congelamento permanente e totale
Aspetto finale Pelle carbonizzata e secca, destinata a diventare polvere Una “statua” perfettamente conservata, come in un criostato
Tempo di conservazione Migliaia di anni (fino alla completa polverizzazione) Miliardi di anni (esposta solo alla lenta erosione dei micrometeoriti)

E se il corpo fosse protetto? Il fattore tuta o navicella

Cosa cambierebbe se il corpo non fosse nudo nel vuoto, ma protetto?

Dentro una navicella pressurizzata (es. la ISS): In questo caso la decomposizione seguirebbe il suo corso naturale, ma con risvolti decisamente bizzarri a causa della microgravità. Senza gravità i liquidi biologici non drenano verso il basso e i gas si accumulano in bolle sparse all’interno dei tessuti. Il risultato sarebbe un disordinato e indescrivibile incubo igienico e olfattivo.

Dentro una tuta spaziale integra (con ossigeno residuo): Per i primi giorni si assisterebbe a una parziale decomposizione anaerobica. Successivamente, consumato l’ossigeno, l’umidità interna inizierebbe a condensarsi e i batteri morirebbero per auto-avvelenamento o mancanza di risorse, trasformando comunque il corpo in una mummia sigillata nel suo guscio ipertecnologico.

Conclusione: L’eterno silenzio biologico

La decomposizione, che sulla Terra associamo all’idea di fine e decadimento, è in realtà un sofisticato e brulicante miracolo biologico che richiede condizioni chimico-fisiche precisissime: aria, acqua liquida e temperature miti.

Nel vuoto dello spazio, questo motore biologico si spegne. Un corpo umano non marcisce, non produce odori, non si dissolve. Diventa un manufatto secco, immobile, quasi eterno — una mummia cosmica.

Una testimonianza muta e affascinante del fatto che la vita, persino nel suo atto finale, ha bisogno di quel sottile, fragile strato di atmosfera che abbiamo la fortuna di chiamare casa.

Per approfondire

Razionalismo Scientifico e Razionalismo religioso

Introduzione

Di tanto in tanto nei reel di Facebook compare uno spezzone del confronto tra la professoressa Margherita Hack e Monsignor Zenti in merito alla diatriba Fede-Scienza registrata nel 2010 presso l’Auditorium di Verona.

Devo dire che, fino a pochi giorni fa, non avevo mai visto per intero questo dibattito tra due menti così diverse. Per chi volesse approfondire, l’intera registrazione è disponibile qui sotto:

Prima di entrare nello specifico, c’è un’impressione generale che balza subito agli occhi: si vede in modo palese la differenza tra chi ha un paio di millenni di retorica alle spalle (Monsignor Zenti e suoi sodali) e chi, invece, è abituato a far parlare i dati senza alcuna capacità di infiocchettare le parole che dice (Professoressa Hack).

Partiamo da una piccola evidenza che sembra di poca importanza ma che, al contrario, dà immediatamente la sensazione che i religiosi siano più abituati degli scienziati a maneggiare le parole e la comunicazione. Mentre la Professoressa Hack e il moderatore individuano Zenti come Monsignore, ovvero col titolo che gli spetta per la carica che ricopre, Monsignor Zenti e sodali non hanno mai usato il termine Professoressa nei confronti di Margherita Hack. Hanno sempre indicato la Professoressa col termine “signora”.

Sapete cosa vuol dire in termini comunicativi? Vuol dire semplicemente privare Margherita Hack della sua autorevolezza scientifica relegandola al ruolo di semplice essere umano (dovrei dire donna) le cui opinioni lasciano il tempo che trovano. In altre parole, il Monsignore ed i suoi sodali fin dall’inizio del confronto hanno cercato di ridimensionare la figura della Professoressa Hack per indebolire le sue parole di scienziata e autorità in ambito scientifico.

Questa situazione è tipica delle culture patriarcali in cui l’uomo, nel senso di maschio, viene visto come superiore alla donna. È capitato anche a me una volta: ero in auto con delle persone ed avevo accanto a me una collega professoressa ordinaria esattamente come me. Ma mentre io venivo indicato come professore, la mia collega veniva costantemente indicata come dottoressa. Come il Monsignore per la Hack, anche queste persone svalutavano il ruolo della mia collega non attribuendole il titolo accademico che le spettava. Avessero indicato anche me come dottore, invece che professore, ci sarei passato sopra. Purtroppo, non fu così.

Questa asimmetria verbale non è solo una sgrammaticatura istituzionale o un retaggio patriarcale. In quel contesto, è una vera e propria postura metodologica. C’è un filo rosso invisibile che lega il rifiuto di chiamare Margherita Hack “Professoressa” al modo in cui il pensiero teologico si rapporta alla scienza. In entrambi i casi, l’obiettivo non è un’indagine paritaria, ma l’imposizione di una cornice predefinita in cui la fede si auto-assegna una posizione di superiorità.

Ed è proprio qui, sotto il velo delle parole infiocchettate della retorica religiosa, che emerge il vero equivoco del dibattito: l’illusione che scienziati e teologi, quando usano la parola “ragione”, stiano parlando della stessa cosa. Monsignor Zenti, come molti intellettuali religiosi, rivendica spesso la razionalità della propria fede. Ma qual è la reale differenza tra il razionalismo di chi studia le stelle e quello di chi difende un dogma?

Due modi opposti di intendere la Ragione

Per capire lo scontro di Verona, bisogna smontare il concetto di “scelta razionale” che i religiosi usano per giustificare il proprio credo. Esistono infatti due razionalismi radicalmente diversi nei presupposti e nei fini: quello scientifico e quello religioso. Nella tabella seguente si riassumono i punti fondamentali che delineano le differenze tra razionalismo scientifico e religioso.

Caratteristica Razionalismo Scientifico Razionalismo Religioso (Teologico)
Punto di partenza Il dubbio e l’osservazione. Non ci sono verità immutabili a priori; tutto deve essere verificato o falsificato. Il dogma o la rivelazione. Si parte da una verità assoluta e accettata per fede (es. l’esistenza di Dio, un testo sacro).
Ruolo della Ragione Strumento di indagine autonomo. Serve a costruire ipotesi, analizzare dati e trarre conclusioni basate sull’evidenza empirica. Strumento di giustificazione e comprensione. Serve a spiegare, ordinare e dimostrare la coerenza interna di una verità già data (fides quaerens intellectum).
Criterio di Verità La riproducibilità e la falsificabilità. Una teoria è valida solo se resiste alle prove empiriche e può essere smentita da dati contrari. La non-contraddizione interna e l’autorità. La verità è valida se è logicamente coerente con i testi sacri o la tradizione e se spiega l’ordine del mondo.
Esito del Processo Sempre provvisorio. Le conclusioni cambiano se emergono nuove prove o modelli matematici più precisi. Definitivo. La conclusione deve necessariamente confermare la premessa iniziale (la fede).

Il Razionalismo Religioso: La Ragione al servizio della Fede

Quando un pensatore religioso (si pensi alla tradizione della Scolastica con San Tommaso d’Aquino) parla di scelta razionale, intende dire che la mente umana può e deve usare la logica per comprendere la creazione. In questo contesto, la razionalità serve a dimostrare che la fede non è assurda. Si usano sillogismi e passaggi logici stringenti per dimostrare, ad esempio, l’ordine dell’universo (l’argomento teleologico) o la necessità di una causa prima (l’argomento cosmologico).

Il limite intrinseco della ragione dogmatica è che essa si muove dentro un perimetro invalicabile. Se un ragionamento logico porta alla conclusione che un dogma è falso, per il razionalismo religioso è il ragionamento umano a essere fallace (o limitato), non il dogma.

Il Razionalismo Scientifico: La Ragione guidata dall’Evidenza

Il razionalismo scientifico (che si fonde strettamente con l’empirismo) non accetta autorità supreme o testi intoccabili. La logica e la matematica sono gli strumenti usati per formulare ipotesi, ma l’arbitro finale è sempre la realtà sperimentale.

In ambito scientifico, se i dati contraddicono l’ipotesi di partenza, per quanto quell’ipotesi fosse logicamente elegante, viene scartata o modificata. Non c’è un obiettivo prefissato a cui il ragionamento deve per forza approdare.

In altre parole

La differenza fondamentale tra le due forme di razionalismo si potrebbero riassumere in una battuta:

  • Il razionalismo scientifico usa la ragione come una bussola per esplorare l’ignoto, pronti a cambiare strada se la mappa si rivela sbagliata.
  • Il razionalismo religioso usa la ragione come un avvocato per difendere e spiegare una causa che ha già deciso essere giusta in partenza.

Conclusioni

Hanno poco da dire Monsignor Zenti e suoi sodali che il loro razionalismo è del tutto simile a quello della Professoressa Hack: non è così. Il suono della parola “razionalismo” è lo stesso, ma il suo significato religioso si trova su lidi opposti a quelli occupati dal significato scientifico dello stesso termine. E a poco conta che i religiosi si sentano offesi quando li si indica come “infantili” perché credono in qualcosa/qualcuno che la Professoressa Hack ha definito come confrontabile alla befana o a babbo natale. Nessuno vieta loro di credere in chicchessia, ma a distanza di sedici anni dal confronto Zenti-Hack, noi scienziati non cadiamo più nelle trappole retoriche dei religiosi. Anche noi abbiamo imparato e sappiamo come difenderci dalle manipolazioni del Signor Zenti e dei suoi seguaci.

La ninidrina

A leggere il titolo di questo articolo vi starete chiedendo di cosa voglio parlare. Ebbene, di certo non voglio discutere di fantasy, né di una città esotica e nemmeno di un nuovo pianeta di un sistema solare lontano anni luce dal nostro.

Niente di tutto questo.

Mi è venuta voglia di descrivere la chimica di una molecola il cui funzionamento mi ha divertito ed appassionato moltissimo quando studiavo la biochimica nell’ormai lontano 1989. Poi vi dirò perché mi è venuta questa voglia.

La nomenclatura

La ninidrina ha nome IUPAC 2,2-diidrossi-1,3-diossoidrindene che, per i non chimici, non risolve alcun mistero. Anzi, volendo, lo complica ancora di più perché introduce una complessità maggiore nel dare un nome a qualcosa usando delle regole molto lontane dalla vita quotidiana. Potremmo pure chiamarlo tirannosauro cityplex, ma cambiare etichetta non permette di comprendere nulla in merito all’oggetto di cui voglio discutere.

Allora andiamo con ordine.

Partiamo dal termine indene.

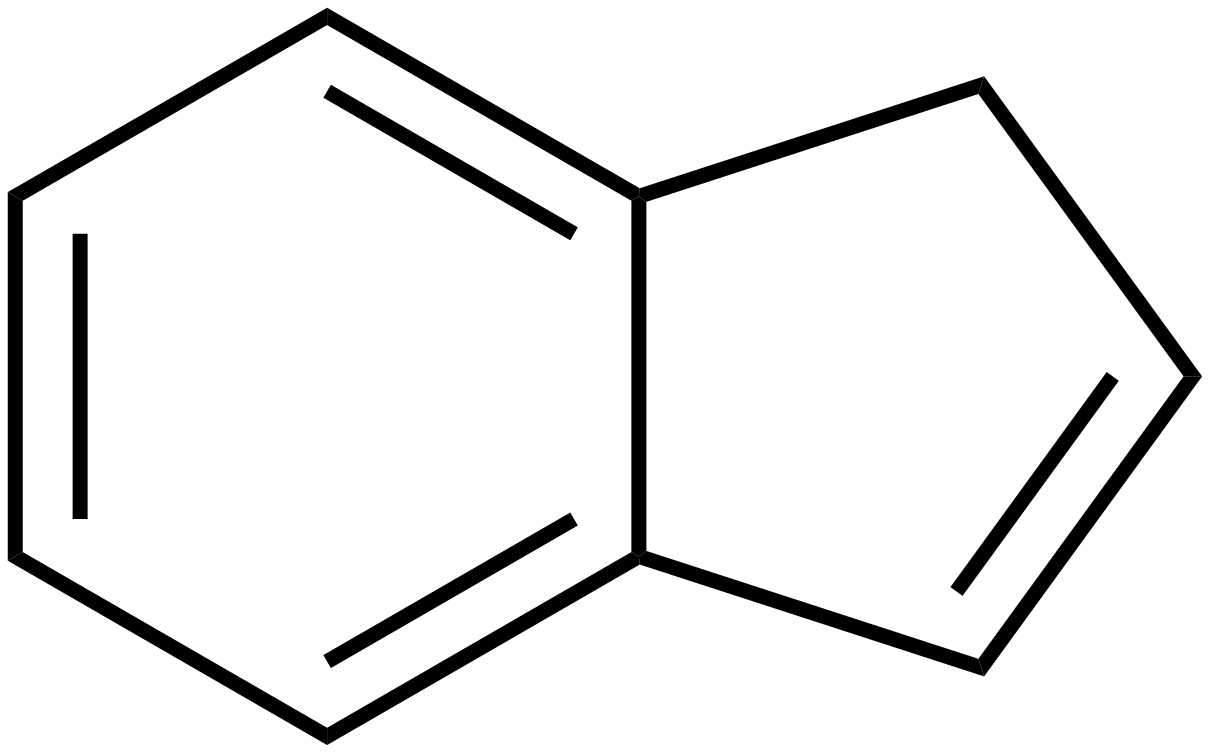
L’indene è la molecola descritta qui sotto. Come si vede, si tratta di un composto formato da un anello benzenico (quello a sinistra, a 6 atomi di carbonio) fuso con un anello ciclopentadienico (quello a destra, a 5 atomi di carbonio). L’anello a 5 termini contiene un doppio legame: quello che vedete in basso a destra. In realtà, i doppi legami nel ciclo a 5 atomi di carbonio sono due, ma non voglio complicarvi ulteriormente la vita con formule ed ibridi di risonanza, per cui decido scientemente di commettere un errore.

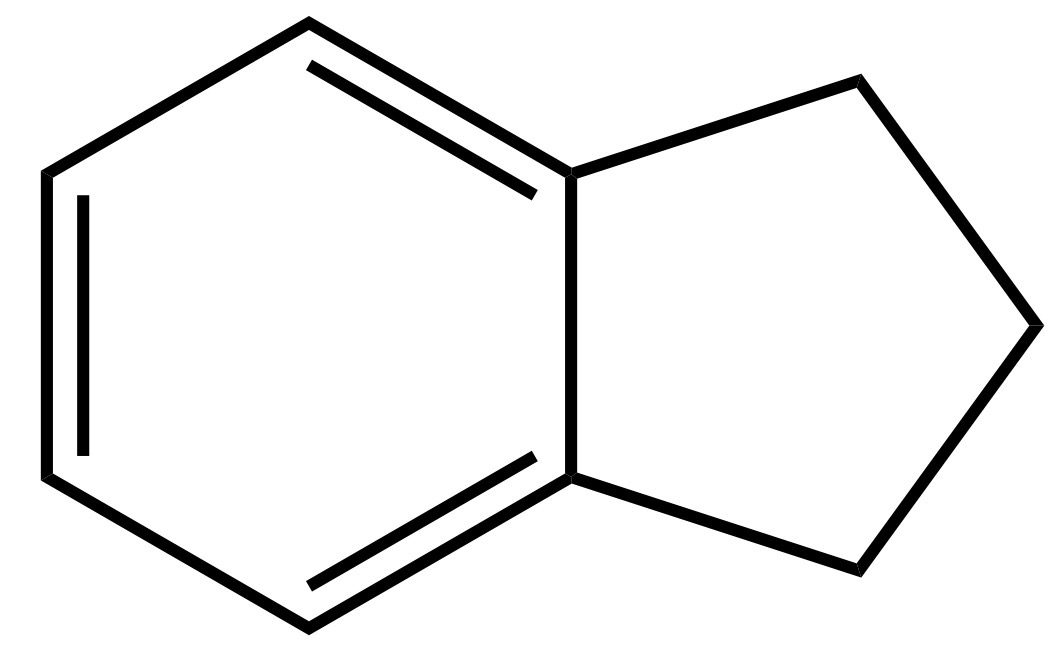
Se dall’anello a cinque atomi di carbonio togliamo quel doppio legame in basso a destra, otteniamo una molecola che si chiama idrindene la cui struttura è quindi:


Il doppio legame lo potete immaginare come un tavolo in cui ci sono due posti vuoti. Ci siete voi che aspettate due vostri amici: i fratelli gemelli idrogeno1 e idrogeno2. Quando arrivano, si siedono e la tavola è completa. Da un punto di vista chimico, togliere un doppio legame significa inserire due atomi di idrogeno, uno su ogni atomo di carbonio coinvolto nel doppio legame, mediante una reazione che si chiama idrogenazione.   Il suffisso “idr” in idrindene, quindi, si riferisce proprio all’indene idrogenato.

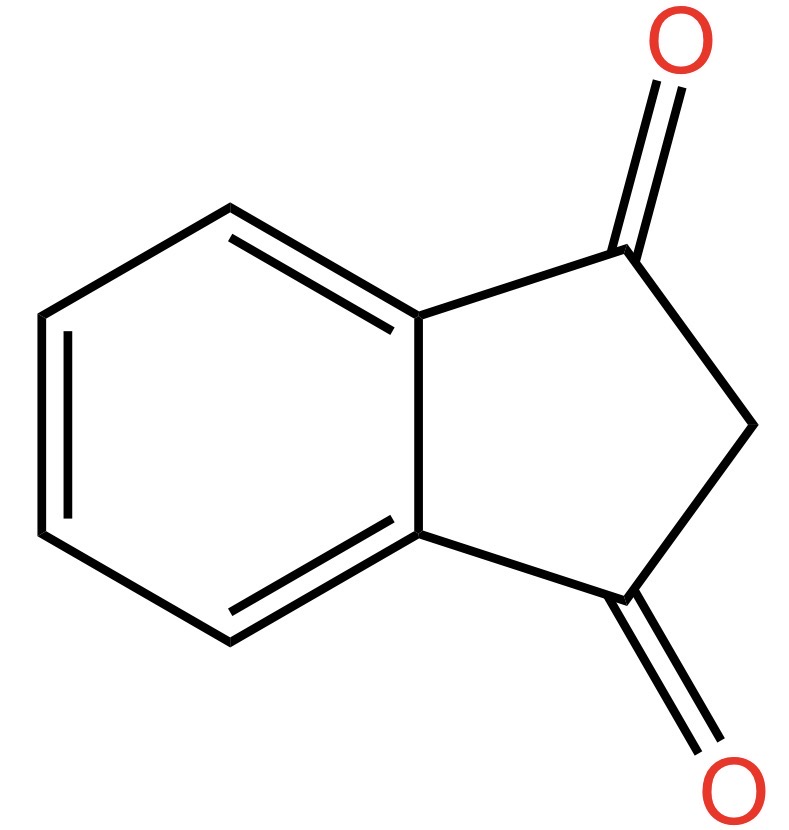
A questo punto mettiamo due atomi di ossigeno legati ciascuno con doppio legame agli atomi di carbonio 1 e 3 come indicato nella figura qui sotto.

Ricordate una cosa importante: in chimica organica vengono attribuiti i numeri civici agli atomi di carbonio presenti in una molecola. Questi numeri civici, che vengono indicati come posizione degli atomi di carbonio all’interno della molecola, servono ai chimici per comprendere di quale atomo nello specifico si stia parlando. A questo punto, scegliete voi quale dei due atomi di carbonio sia 1 e quale 3. Però tranquilli perché non c’è nessuna risposta giusta o sbagliata: la molecola è simmetrica; quindi, potete ribaltarla come in uno specchio e tutto funziona allo stesso modo.

La reazione che produce questo oggetto chimico si chiama ossidazione, ma non importa il nome e proseguiamo. Andiamo avanti aggiungendo che i due gruppi ossigenati così ottenuti vengono indicati come “diosso”. Da qui il termine diossoidrindene. Ma dal momento che gli atomi di carbonio legati con doppio legame con l’ossigeno sono in posizione 1 e 3, il nome corretto è 1,3-diossoidrindene.

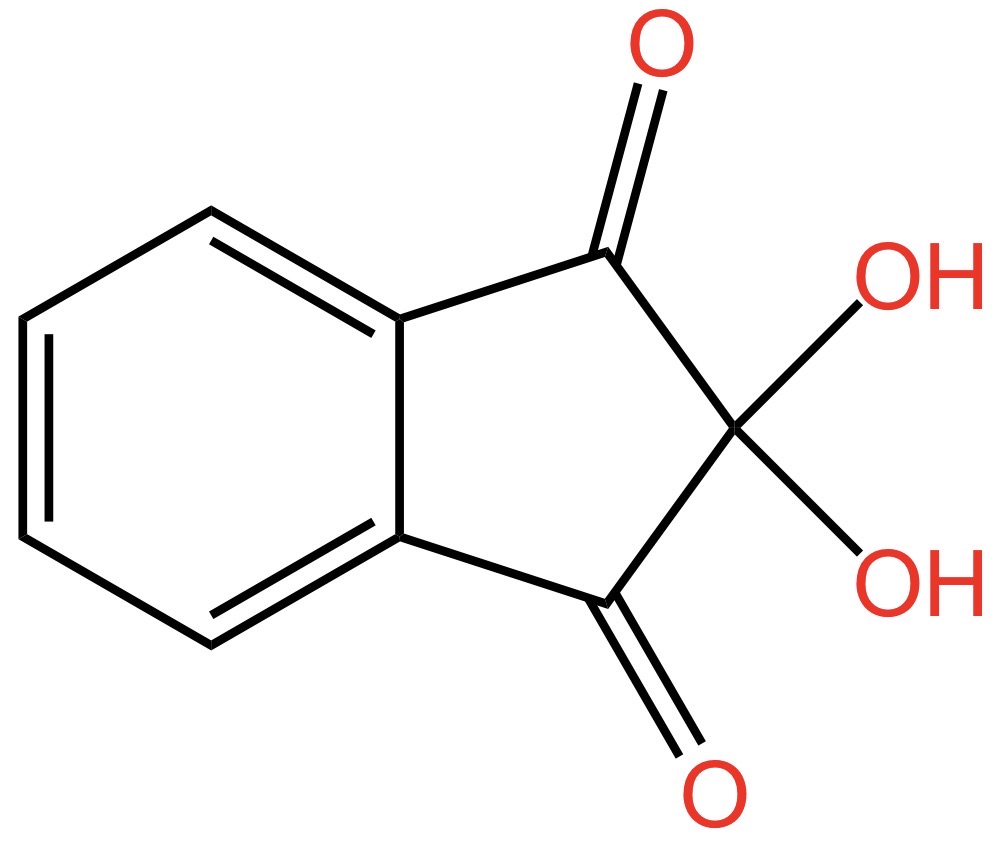
Continuiamo a mettere atomi di ossigeno e piazziamo due gruppi -OH, che si chiamano ossidrile oppure idrossile o, ancora, idrossi, sul carbonio in posizione 2. Otteniamo la struttura indicata nella seguente figura:

Poiché gli ossidrili in posizione 2 sono due, il nome dell’oggetto mostrato nella figura sopra diventa: 2,2-diidrossi-1,3-diossoidrindene… per gli amici intimi: ninidrina.

Quindi riassumendo

2,2-diidrossi è il suffisso che usiamo per indicare due gruppi -OH legati entrambi all’atomo di carbonio in posizione 2. Poiché gli ossidrili sono due, il numero civico del carbonio va ripetuto due volte mentre il suffisso “di” davanti a “idrossi” si riferisce proprio al numero di gruppi -OH presenti.

1,3-diosso è il suffisso che usiamo per indicare due atomi di ossigeno legati con doppio legame agli atomi di carbonio ai civici 1 e 3.

Il suffisso “idr” si riferisce a un sistema chimico che ha perso un doppio legame per effetto della reazione con idrogeno.

Infine, indene è la molecola da cui siamo partiti.

Ed ora?

Ed ora diamo un’occhiata al carbonio al civico 2 che è legato a due gruppi ossidrili.

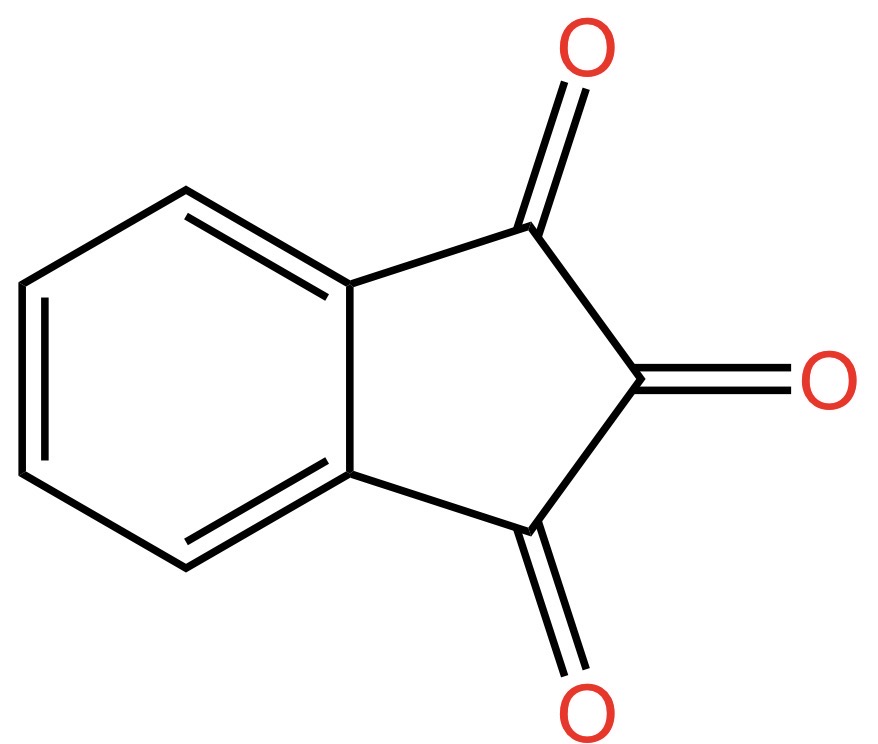
Dovete sapere che una molecola che contiene un gruppo ossidrile si chiama alcol. Sì… nel linguaggio comune il termine si riferisce all’ingrediente più importante di tante bevande: dal vino al bloody Mary, ovvero l’alcol etilico. Ma, in chimichese il termine alcol si riferisce a una classe di molecole che contengono il gruppo -OH. Quando nella stessa molecola sono presenti due gruppi ossidrili, questa viene indicata come diolo. Se i gruppi ossidrili sono sullo stesso atomo di carbonio, come nel caso della ninidrina, si parla di dioli geminali. Geminale deriva da gemello. I due -OH sullo stesso atomo di carbonio sono gemelli e come fratelli tendono a litigare. In effetti, i dioli geminali sono instabili perché i due gruppi -OH sullo stesso atomo di carbonio non stanno bene assieme e fanno a cazzotti. Cosa succede? Tendono a reagire per formare un doppio legame C=O in posizione 2, come nella figura qui sotto.

Adesso giochiamo ad aguzza la vista. Guardate cosa abbiamo combinato lì nella parte destra della molecola: ai civici da 1 a 3 ci sono tre gruppi C=O. Sembrano uguali, non è vero? Ma non è così.

Pur essendo uguali i tre gruppi hanno stabilità differente, o, potremmo anche dire, hanno reattività differente. In altre parole, tendono a reagire in modo diverso quando sono in presenza di particolari reagenti che andremo a vedere fra poco.

Il ruolo dell’elettronegatività

Il titolo di questo paragrafetto riporta una parolaccia: elettronegatività. Ma cos’è ‘sta roba?

Dobbiamo ricordarci che il chimichese è un linguaggio col proprio alfabeto e con le proprie regole di grammatica e sintassi. L’alfabeto è la tavola periodica. Essa contiene tutte le lettere, gli elementi chimici, che combinate formano le parole. Queste, a loro volta, messe assieme portano alle frasi chimiche che noi chimici ci ostiniamo a chiamare reazioni.

Sembra semplice, ma non lo è, purtroppo. E meno male… direi… altrimenti che ci sto a fare io qui?

Una delle regole grammaticali che a noi chimici piace utilizzare per spiegare cose che altrimenti sarebbero incomprensibili è l’elettronegatività. Il termine si riferisce alla tendenza di un elemento chimico a trattenere gli elettroni. Sì… proprio quegli affarini che si muovono intorno al nucleo secondo delle modalità che non ci è dato conoscere e che si presentano in delle regioni di spazio che amiamo definire col nome esotico di orbitali.

Più alta è la capacità di un elemento di trattenere gli elettroni, maggiore è il valore numerico dell’elettronegatività.

Sapete che il primo a quantificare l’elettronegatività è stato Linus Pauling? È uno dei miei idoli assieme a Richard Feynman. Li adoro entrambi.

Nella scala Pauling, l’elemento più elettronegativo è il fluoro (F), a seguire l’ossigeno. Solo molto dopo arriva il carbonio.

Quando scriviamo qualcosa come C-O, oppure C-H, stiamo riportando una interazione, che in chimichese si chiama legame, tra due elementi: carbonio e ossigeno, nel primo caso, carbonio e idrogeno, nel secondo.

Il trattino tra i due elementi è la rappresentazione grafica del  legame chimico. Esso coinvolge due elettroni. In altre parole, il trattino sta a indicare due elettroni coinvolti nell’interazione tra gli elementi considerati.

Detto questo torniamo all’elettronegatività. Abbiamo detto che l’ossigeno è più elettronegativo del carbonio. Quindi, per effetto di questo, accade qualcosa di speciale nella distribuzione degli elettroni del legame C-O.

Siete curiosi di sapere cosa significa in un linguaggio meno chimichese?

Carbonio e ossigeno sono due persone. Il primo è un signore distinto col monocolo e il bastone; un signore d’altri tempi. Il secondo è un energumeno palestrato con la fissa per il wrestling. I due decidono di giocare al tiro alla fune. Chi vince secondo voi? Sì… l’energumeno palestrato.

Ecco… l’ossigeno, in virtù della sua maggiore elettronegatività, si comporta come il palestrato tirando verso di sé la corda con forza maggiore rispetto a quella usata dal signore di altri tempi. Ritornando al chimichese, gli elettroni del legame carbonio-ossigeno passano più tempo vicino a quest’ultimo che al carbonio. Nel linguaggio chimico più forbito, quello che userebbe il signore di altri tempi, la densità elettronica è spostata verso l’ossigeno. Questo vuol dire che, mediamente nel tempo, il carbonio è più elettropositivo dell’ossigeno. Scusate… traduco: per effetto della maggiore elettronegatività dell’ossigeno, il carbonio presenta una deficienza (nel senso di mancanza) elettronica ed ha una parziale carica positiva. Al contrario, l’ossigeno per gli stessi motivi ha una parziale carica negativa.

Adesso allarghiamo il campo. Se l’ossigeno richiama a sé gli elettroni del legame C-O, il carbonio, per effetto della sua deficienza elettronica, richiama a sé gli elettroni dei legami contigui. Quindi, se consideriamo qualcosa come C-C-O, anche il carbonio più lontano dall’ossigeno ha una parziale carica positiva indotta dal richiamo elettronico del lontano ossigeno.

Complichiamoci maggiormente l’esistenza e consideriamo un sistema come: O-C-C-C-O. Qui abbiamo tre atomi di carbonio e due di ossigeno. Gli atomi di carbonio alle estremità sono, ognuno, legati ad un atomo di ossigeno più elettronegativo. Questo vuol dire che il carbonio centrale risente del richiamo di due atomi di ossigeno. Come conseguenza, ha un potenziale elettropositivo (cioè una parziale carica positiva) maggiore rispetto al medesimo atomo di carbonio del sistema C-C-O.

Torniamo alla Ninidrina

Fatta la necessaria premessa sull’elettronegatività, riprendiamo la struttura della ninidrina in cui i due gruppi -OH hanno fatto a cazzotti. Per semplicità la riporto di nuovo qui di seguito:

Come vedete, abbiamo un C=O centrale, quello al civico 2, che risente dell’effetto dei due C=O al civico 1 e al civico 3. Pur avendo la stessa natura chimica, a causa degli effetti descritti prima, i C=O al civico 1 e 3 sono meno reattivi del C=O al civico 2. In pratica, la carica parziale netta positiva sul carbonio in 2 è maggiore rispetto a quelle degli atomi di carbonio in 1 e 3.

Cosa accade adesso?

Stiamo passeggiando nel parco. Stiamo per gli affari nostri quando incrociamo la nostra anima gemella: è amore a prima vista.

Ecco… il carbonio 2 della ninidrina povero di elettroni incrocia un sistema chimico che, invece, ne è ricco. Quale? Uno come R-NH2, per esempio. Questa è la formula generale dei composti che si chiamano ammine. L’azoto (N) è ricco di elettroni. Ne ha talmente tanti che quando si avvicina alla ninidrina viene attratto dalla sua anima gemella, ovvero il carbonio povero di elettroni in posizione 2. E cosa accade?

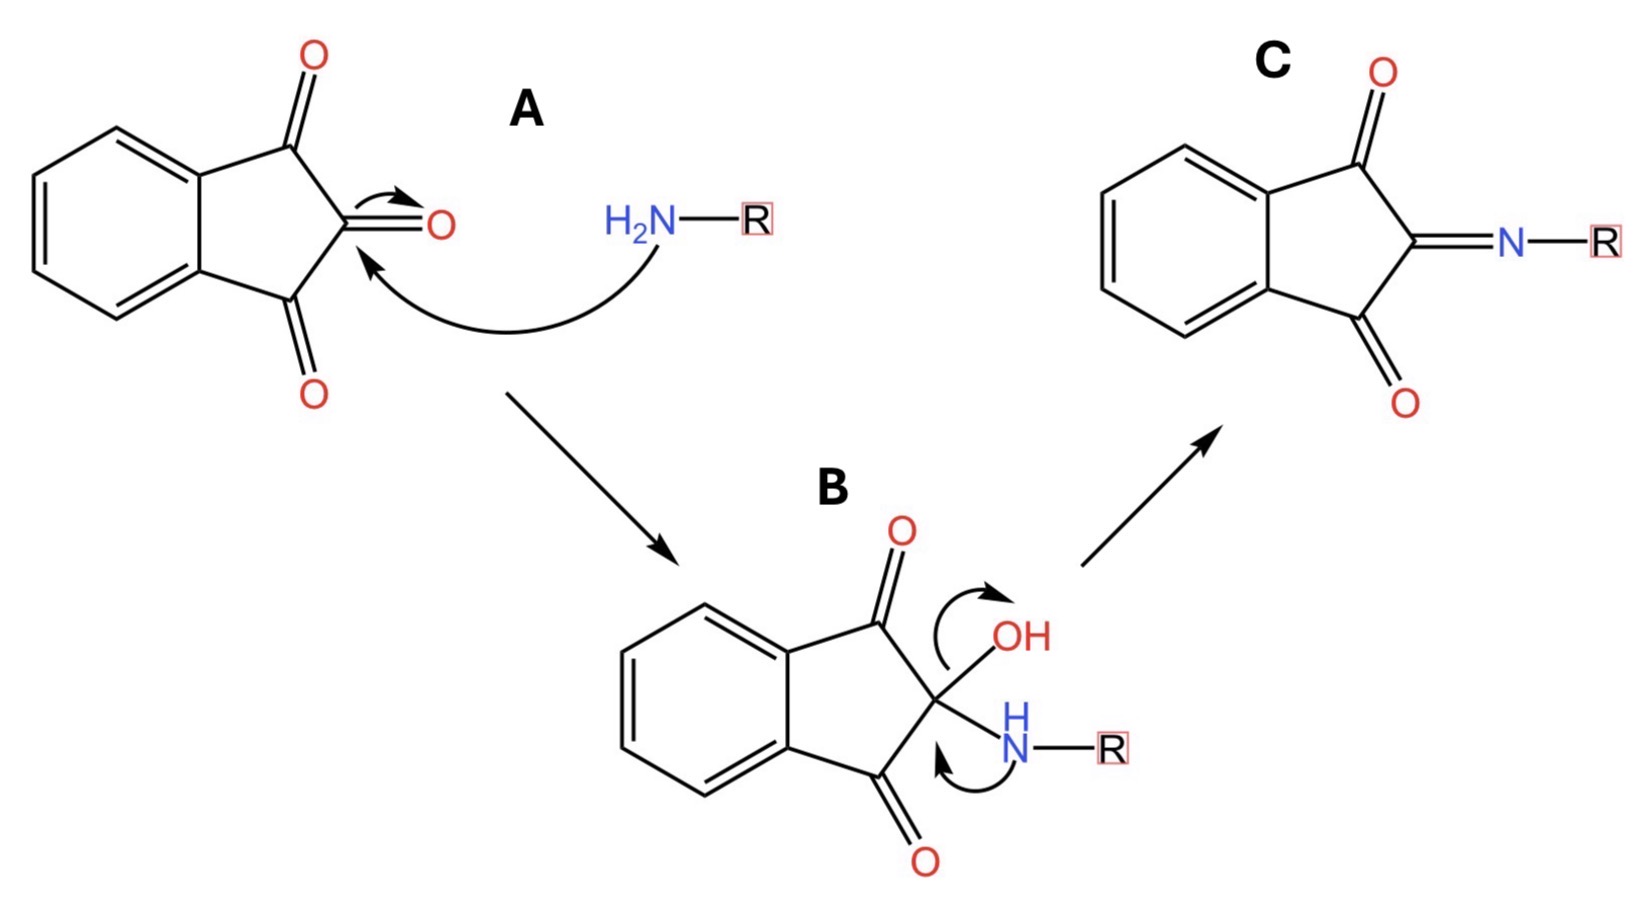
Guardate la figura qui sotto. In particolare la parte A. Qui le due anime gemelle si incontrano e si legano indissolubilmente. Le frecce curve indicano il movimento di elettroni dal sistema chimico che ne contiene di più a quello che ne contiene di meno. Si forma la molecola descritta nella parte B della medesima figura. In questa molecola intermedia, l’azoto è ancora ricco di elettroni. Di conseguenza li usa per rendere ancora più indissolubile il legame con la sua anima gemella portando alla formazione del composto riportato nella parte C della figura.

Sapete cosa è quella molecola? È un cromoforo, ovvero una molecola in grado di colorare di violetto una soluzione che la contiene. In altre parole, quando la ninidrina viene a contatto con una ammina o un altro sistema contenente un gruppo amminico, pensiamo, per esempio, agli amminoacidi, avviene una reazione che porta ad una soluzione colorata. L’intensità del colore è direttamente proporzionale alla quantità di sistema amminico che reagisce con la ninidrina. Nell’ambito della chimica biologica, la ninidrina è un utile strumento per quantificare gli amminoacidi con gruppi amminici primari (cioè del tipo RNH2) in sistemi proteici complessi.

La ninidrina nell’analisi forense

E veniamo al perché vi ho raccontato della ninidrina.

È da un po’ di tempo che si sente parlare del caso di Garlasco e dell’arresto quantomeno strano di Stasi. I diversi commentatori sui vari canali presenti in rete parlano ripetutamente di test della ninidrina per il rilievo delle impronte digitali. Ecco… ho l’impressione, ma è solo una mia opinione, che tutti parlino di qualcosa che non conoscono.

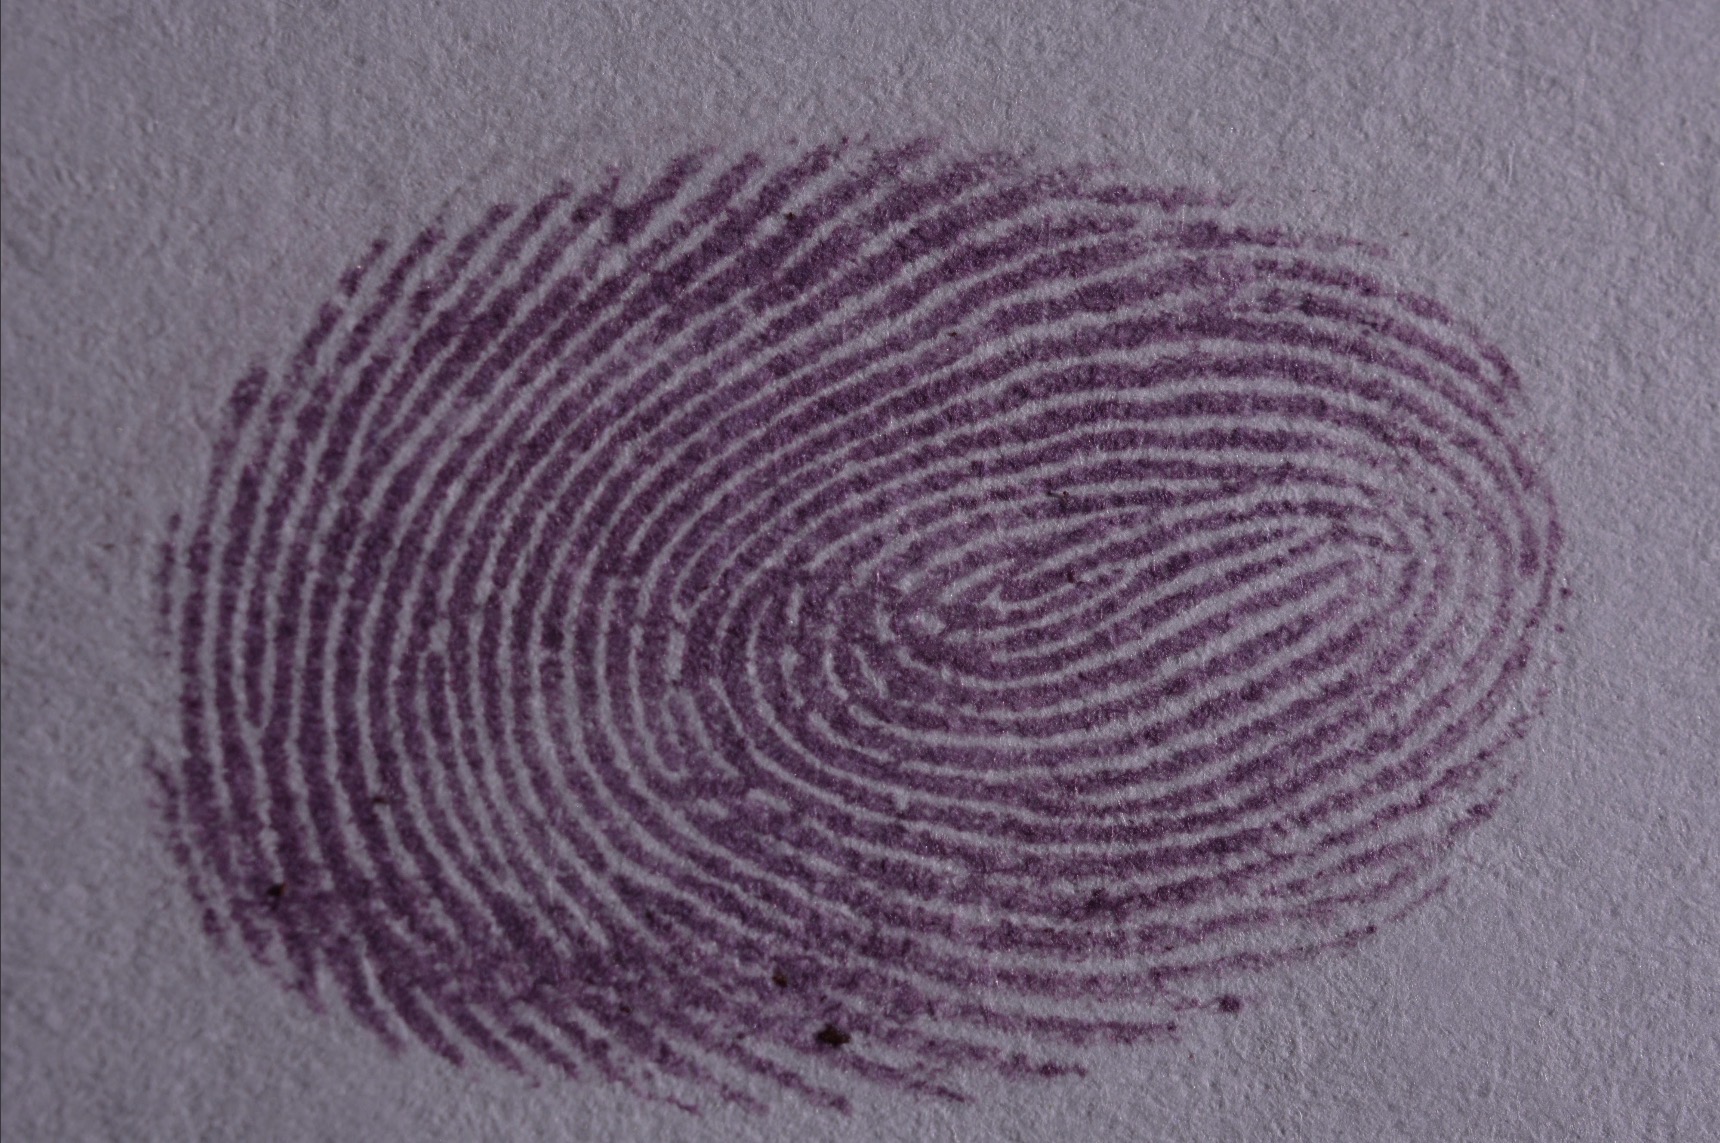
Cosa sono le impronte digitali? Si tratta di “immagini” dei nostri polpastrelli generate dal contatto con mezzi più o meno porosi. Da un punto di vista chimico, queste impronte contengono acqua, sali minerali, vitamine, amminoacidi e altro. Per il rilievo delle impronte si usa una soluzione di ninidrina che, reagendo con gli amminoacidi secondo lo schema appena descritto, produce un’immagine colorata che può essere studiata per consentire l’identificazione della persona che ha toccato quel dato oggetto.

Conclusioni

Perché la ninidrina mi divertiva quando studiavo la biochimica? Beh… da tutto quanto ho scritto è chiaro che conoscere la ninidrina significa avere in mente una quantità di conoscenze chimiche non indifferente. Non sto parlando solo della nomenclatura. Quella è una banalità. Bisogna avere conoscenze approfondite di chimica generale, chimica organica e quantomeccanica. Quello che vi ho raccontato non lo trovate scritto nei libri, ma lo ottenete dalla conoscenza comparata di diverse discipline chimiche. Ecco perché, quando sento qualcuno parlare della ninidrina come fosse un semplice reagente, sorrido. Per me è stata molto di più: è stata la prova che la chimica non è un insieme di nozioni, ma un modo di vedere il mondo. E quel viola, in provetta, era la conferma che avevo cominciato a vederlo davvero.

Grazie a tutti voi che avete avuto la pazienza di condividere con me un istante della mia vita da studente.

Il destino della materia vivente: filosofia naturale delle trasformazioni

Quando faccio lezione mi accorgo spesso di una cosa: usiamo parole enormi con una naturalezza disarmante, come se fossero trasparenti. E invece no: dentro quelle parole ci sono scelte culturali, immagini implicite, scorciatoie del linguaggio.

Una delle più insidiose è “fertilità”. La diciamo e pensiamo subito a un raccolto più abbondante, a una resa migliore, a un suolo “che produce”. È una definizione comprensibile – ma è anche la più stretta, e in un certo senso la più povera.

Se vi capita di prendere in mano una zolla dopo una pioggia leggera, sentirne l’odore e vederne la grana, capite che non state toccando un semplice “supporto” per le radici. State tenendo tra le dita un sistema che respira, scambia, trattiene, rilascia: un’interfaccia fra roccia, acqua, aria e vita.

Fertilità

In ecologia e in scienza del suolo, la fertilità è soprattutto questo: la capacità di un suolo di sostenere reti di vita nel tempo, fornendo acqua, nutrienti, habitat, e un ambiente chimico-fisico in cui i processi biologici possono avvenire.

Detto così sembra astratto, ma ha una conseguenza importante: esistono suoli “fertili” anche dove non immaginiamo alcuna produttività agricola. I suoli desertici, le saline, i suoli polari o quelli sottilissimi su rocce giovani possono avere una fertilità minima e altamente specializzata – sufficiente però a sostenere comunità adattate a quelle condizioni estreme.

Non è romanticismo: è una questione di funzioni. Un suolo può essere povero di sostanza organica e tuttavia ospitare cicli del carbonio e dell’azoto; può avere pochissima acqua disponibile e tuttavia mantenere, per brevi finestre temporali, un’attività microbica sorprendente. La fertilità, in questo senso, è la misura della possibilità.

Cos’è la vita

Ed è qui che, di solito, faccio inciampare (con gentilezza) i miei studenti: “Cos’è la vita?”. Sembra una domanda scolastica, e proprio per questo le risposte arrivano spesso automatiche.

“La vita è la capacità di riprodursi”, dicono. Allora la domanda successiva è inevitabile: un mulo è vivo oppure no? Se lo è, la riproduzione non può essere il criterio decisivo.

“La vita è movimento, reazione, pensiero”. E allora che facciamo con una spora dormiente, con un seme in quiescenza, con un organismo in letargo? È vivo anche quando non ‘fa’ nulla di evidente. E un robot che si muove, reagisce e impara? Siamo tentati di chiamarlo vivo solo perché imita alcune proprietà del vivente.

Questi esempi servono a un punto semplice: la vita non risiede in una singola proprietà isolata. Il polmone da solo non è vivo. Il cuore da solo non è vivo. Neanche una molecola – per quanto sofisticata – è “viva” in sé. È soltanto quando molte parti diverse cooperano, in un equilibrio dinamico, che appare qualcosa di qualitativamente nuovo.

Vita come emergenza metabolica e autopoiesi

Se dovessi azzardare una definizione operativa, la formulerei così: la vita è una proprietà emergente che nasce dalla combinazione non lineare di molti fattori chimici e fisici, quando questi fattori si organizzano in una rete capace di mantenersi e rigenerarsi.

Il cuore di questa rete è il metabolismo: un intreccio di reazioni che trasforma materia ed energia e, soprattutto, mette in relazione fra loro metaboliti primari e secondari. I primi sono le “monete” fondamentali della cellula (zuccheri, amminoacidi, nucleotidi, lipidi); i secondi sono un immenso repertorio di molecole che modulano, proteggono, comunicano, competono, cooperano. Non sono accessori: spesso sono i nodi che rendono possibile l’adattamento, la regolazione, la risposta.

La cosa decisiva è l’intreccio: queste vie non scorrono in linea retta. Si parlano attraverso feedback, soglie, amplificazioni e smorzamenti. È una dinamica non lineare: piccole variazioni in un punto possono produrre grandi effetti altrove, e viceversa. Da questo tessuto di reazioni nasce la capacità di stare “lontano dall’equilibrio” senza collassare.

Quando questa rete metabolica sostiene un meccanismo autopoietico – cioè, quando il sistema produce e rinnova continuamente i propri componenti (membrane, enzimi, strutture), mantenendo un confine e una coerenza interna – allora riconosciamo il vivente. Non perché sia magico, ma perché ha una proprietà organizzativa che la pura chimica, lasciata a sé stessa, non mantiene a lungo.

Morte

La morte, vista così, è meno misteriosa di quanto sembri. Non è la fine della materia: è la fine di quell’organizzazione autopoietica.

Quando l’organizzazione si interrompe, cessa il controllo: i gradienti chimici si annullano, le membrane perdono integrità, i compartimenti cellulari si aprono. Le reazioni non si fermano: cambiano regime. Passano da un metabolismo regolato a una chimica di degradazione, guidata dalla termodinamica e facilitata da enzimi, idrolisi, ossidazioni, microbi.

Le molecole che fino a un istante prima partecipavano all’ordine interno dell’organismo non “muoiono”: tornano disponibili. Si spezzano, si dissolvono, si ricombinano. Rientrano nei cicli che attraversano suolo, aria e acqua.

Tre destini della materia organica

Qui vale la pena essere precisi, perché una semplificazione comune è pensare che tutto “torni subito in inorganico”. In realtà i destini sono almeno tre e hanno tempi molto diversi.

1) Mineralizzazione rapida. Una parte della materia organica viene degradata relativamente in fretta: carbonio che torna a CO₂, idrogeno che torna a H₂O, azoto che passa per ammonio e nitrati, zolfo che transita in forme ossidate o ridotte. È il flusso che alimenta gran parte del ciclo biogeochimico visibile.

2) Incorporazione e stabilizzazione. Un’altra parte non scompare: entra nella biomassa microbica e, soprattutto, nella cosiddetta necromassa microbica (i residui cellulari). Questi frammenti possono legarsi alle superfici minerali, essere protetti dentro aggregati, diventare meno accessibili agli enzimi. Qui il suolo funziona come archivio chimico-fisico: non per ‘mistero’, ma per protezione e limitazione della disponibilità.

3) Trasporto e trasformazioni lente. Una quota viene trasportata: disciolta nell’acqua, adsorbita a particelle fini, trascinata verso acque sotterranee o corsi d’acqua, o rilasciata come composti volatili. In questi percorsi può essere trasformata più volte, in modo discontinuo, con tempi che si allungano enormemente.

Queste tre strade coesistono. E la loro proporzione dipende da condizioni molto concrete: ossigeno, umidità, temperatura, tessitura, mineralogia, struttura degli aggregati, qualità della materia organica, comunità microbiche.

E il DNA?

Nella nostra immaginazione il DNA è “il codice”, la memoria più profonda della vita. Ma senza il contesto che lo mantiene – riparazione  replicazione, protezione dentro strutture – anche quel codice si frammenta.

Questo non significa che non restino tracce: in certe condizioni parti di acidi nucleici possono persistere, essere adsorbite, essere rilevate a distanza di tempo. Ma la cosa importante è un’altra: l’informazione biologica non vive nei nucleotidi inerti; vive nel circuito che la interpreta e la rinnova.

Per questo la morte non è la scomparsa del materiale genetico in quanto materia, ma la perdita del sistema che lo rende funzione.

Il tempo del carbonio

La vita ha un tempo breve; la materia no. Un organismo può durare decenni, un ecosistema secoli, una specie milioni di anni. Gli atomi, invece, non hanno biografia: hanno traiettorie.

Gli atomi che oggi ci compongono arrivano da lontano: dalle piante che hanno fissato carbonio dall’atmosfera, dal suolo che ha trattenuto e trasformato residui, dall’acqua che ha sciolto e trasportato ioni, da catene alimentari e decomposizioni ripetute. In parte – su scale molto più grandi – vengono perfino da storie stellari.

E un domani, quando la trama che ci tiene insieme si allenterà, torneranno disponibili per altri sistemi. Non è una profezia numerica, è un modo probabilistico di guardare un ciclo globale: mescolamento e riuso rendono inevitabile che la materia passi attraverso molte forme. Su tempi lunghi, la possibilità cresce; non perché “debba”, ma perché può.

La continuità della materia non ci diminuisce. Ci colloca in un flusso più grande, in cui ogni configurazione è temporanea e tuttavia reale. La vita è una delle forme più straordinarie di questa temporaneità: ordine locale mantenuto consumando energia, nel corpo fragile di una rete metabolica.

Conclusioni

Se la vita è un’emergenza, allora i sistemi che la rendono possibile meritano un rispetto diverso: non come scenografia, ma come infrastruttura. Il suolo, l’acqua, l’aria – e le loro interazioni – sono i luoghi in cui la materia impara, per un attimo, a diventare organismo.

La materia non conosce finali: conosce trasformazioni. La vita è la fase in cui la materia trova voce, organizzazione, autoregolazione e poi la restituisce al flusso da cui proviene. E proprio perché è una parentesi, vale la pena guardarla senza slogan: con precisione, e con meraviglia.

“Lo dice la scienza”: un caso studio sul confine fra metodo scientifico e decisioni normative

Introduzione

Qualche giorno fa ho pubblicato un breve articolo [link] in cui riflettevo sull’uso sempre più frequente della locuzione “lo dice la scienza” nella divulgazione scientifica. Ho notato come molte riviste accreditate e numerosi divulgatori ricorrano a questa espressione per rafforzare le conclusioni dei propri ragionamenti.

In quell’articolo evidenziavo come tale locuzione sia problematica sia sul piano dei contenuti sia su quello della comunicazione: la scienza non è un soggetto che parla, non produce verità assolute e non funziona per atti di fede.

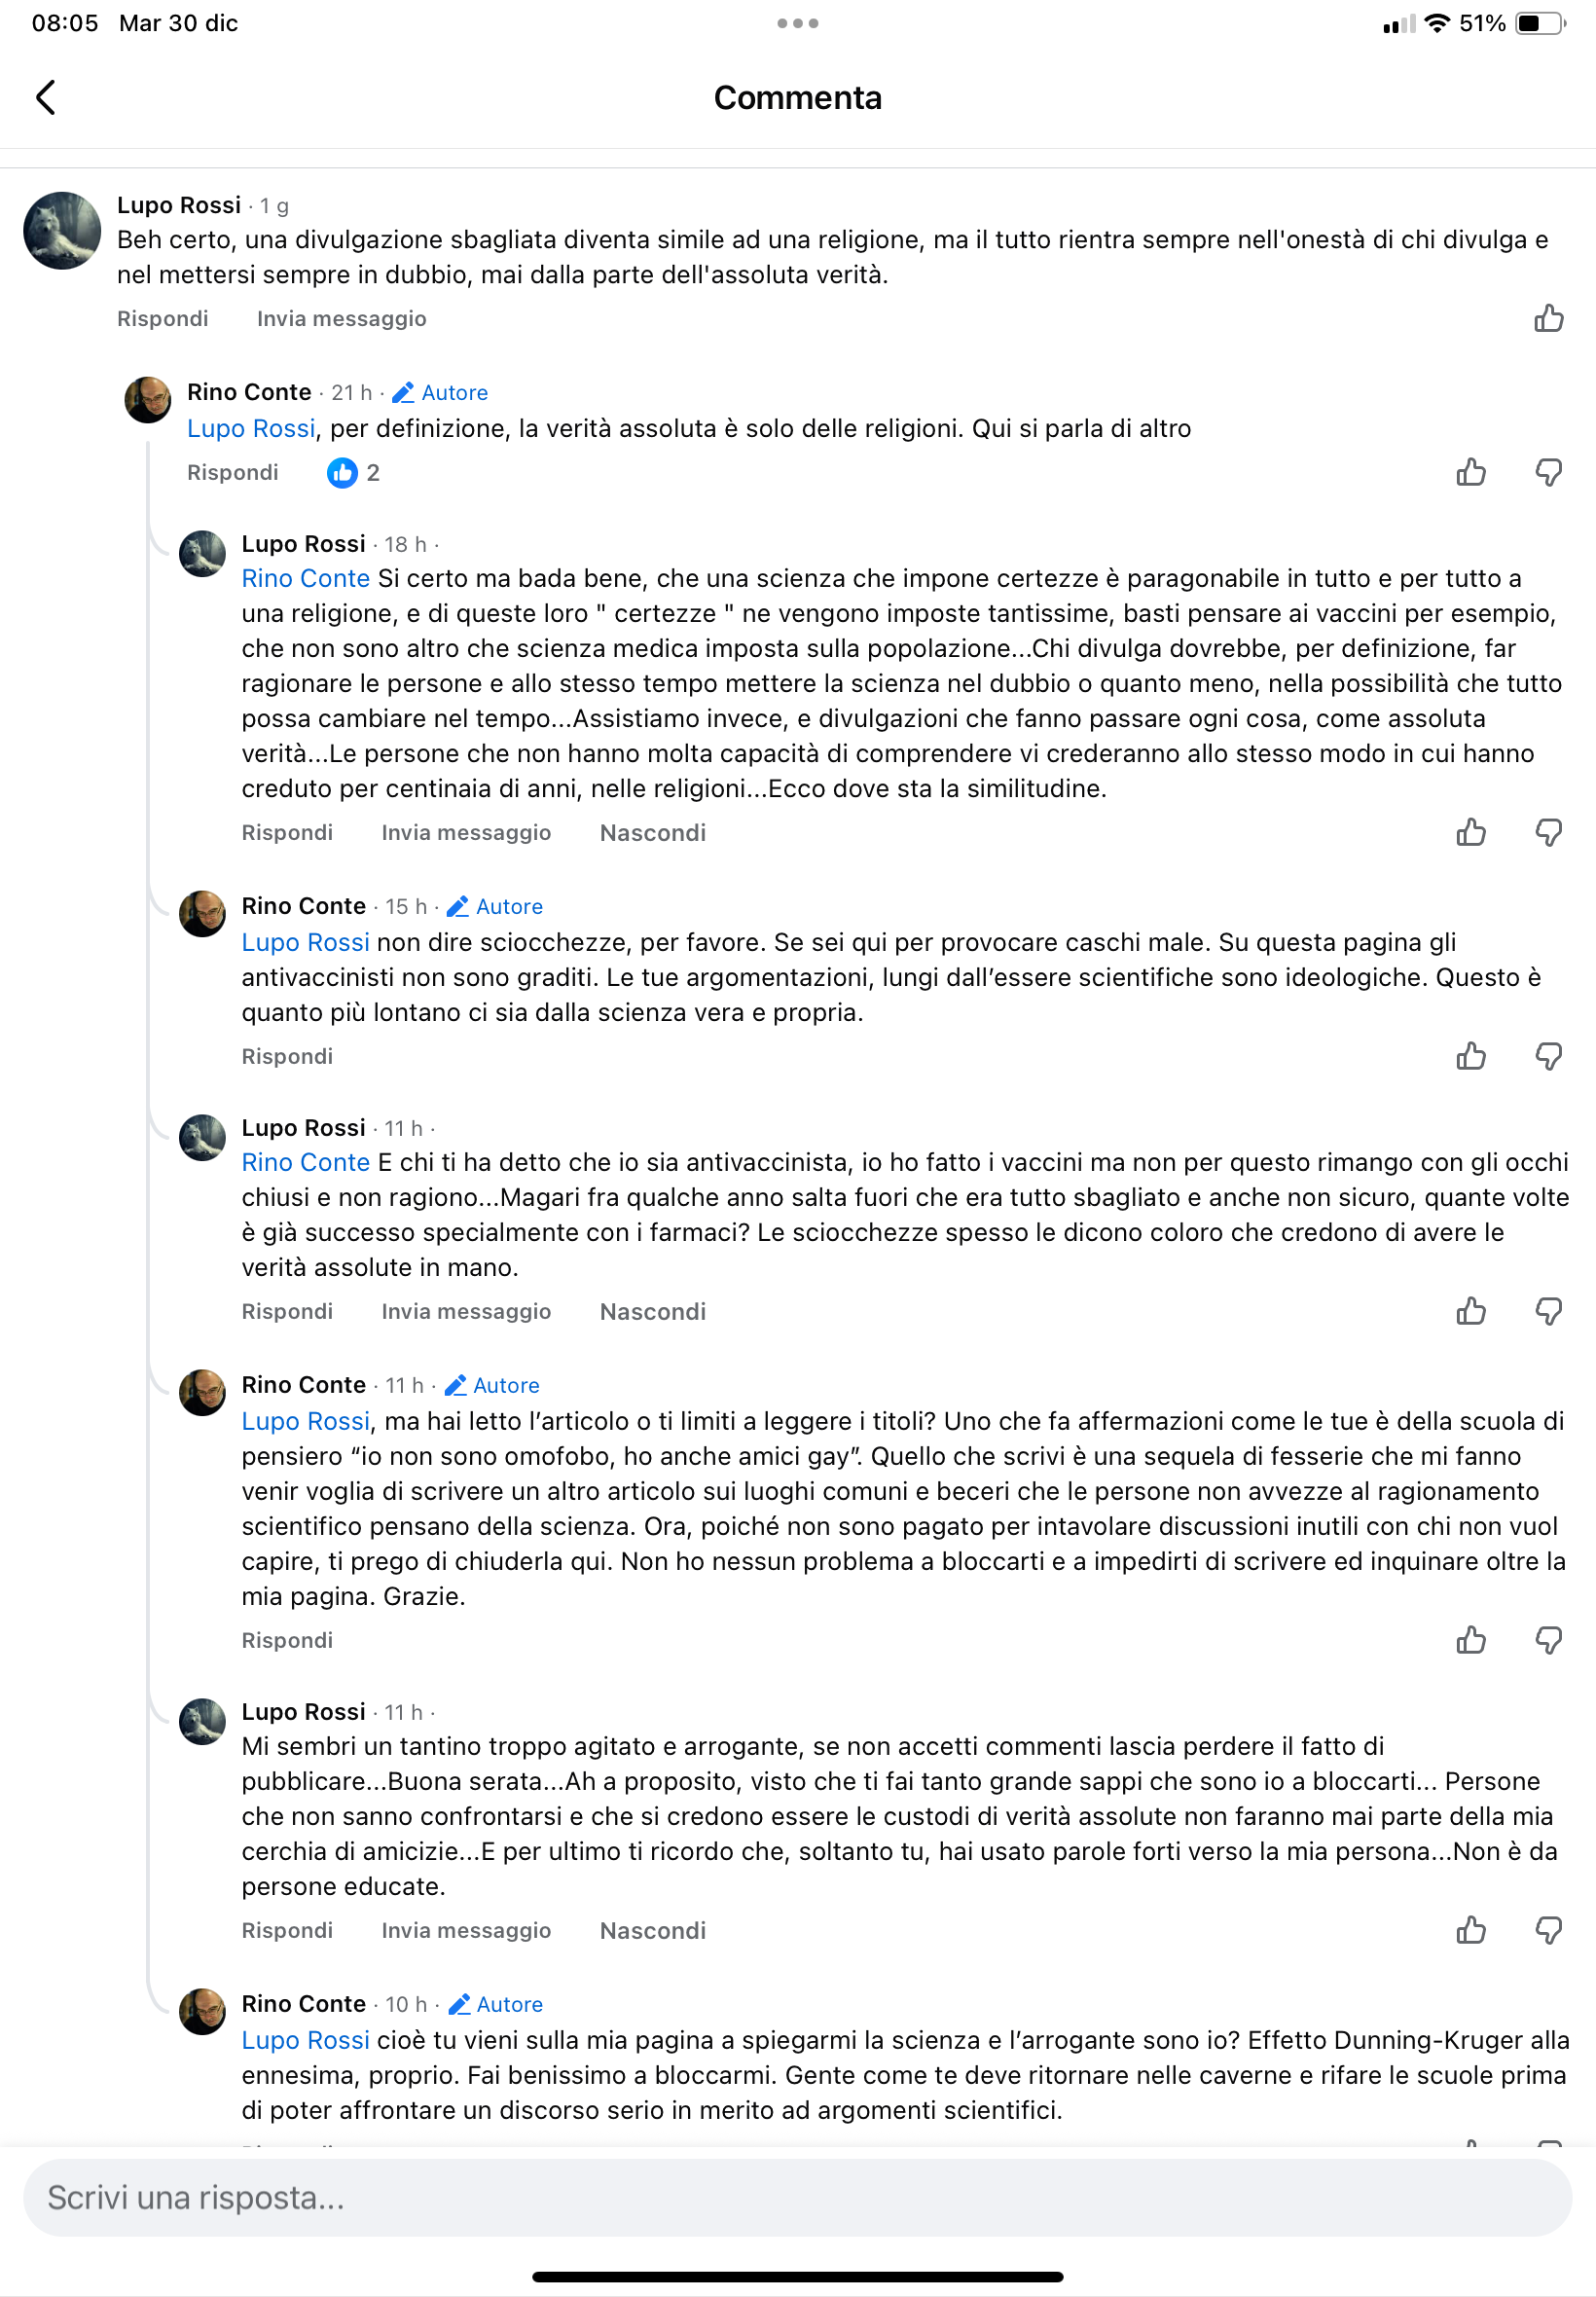
A seguito della pubblicazione, si è sviluppata una discussione pubblica con un lettore (Figura 1) che rappresenta un caso interessante di fraintendimento del confine fra metodo scientifico e decisioni normative. È questo scambio, più che le persone coinvolte, a costituire l’oggetto dell’analisi che segue.

Figura 1. Estratto di uno scambio pubblico avvenuto nei commenti a un articolo precedente. Il dialogo è riportato come caso studio per illustrare alcuni fraintendimenti ricorrenti nel dibattito pubblico sul rapporto fra metodo scientifico e decisioni normative. Lo scopo non è valutare le persone coinvolte, ma analizzare gli argomenti e i passaggi concettuali.

Il metodo scientifico non “impone” nulla

Uno degli equivoci più ricorrenti nel dibattito pubblico consiste nel trattare la scienza come un’autorità normativa, capace di imporre comportamenti, obblighi o divieti. Ma il metodo scientifico non ha questo ruolo.

La scienza:

  • formula ipotesi,
  • raccoglie dati,
  • costruisce modelli,
  • li testa e li migliora.

Non decide cosa si deve fare.

Le decisioni — sanitarie, politiche, sociali — sono sempre atti normativi, presi da istituzioni e governi sulla base delle evidenze disponibili, ma anche di valutazioni etiche, economiche e sociali.

Confondere questi due piani significa attribuire alla scienza un potere che non ha, e allo stesso tempo criticarla per responsabilità che non le competono.

Il dubbio scientifico non è sospensione permanente del giudizio

Un secondo elemento che emerge chiaramente dal caso studio è l’uso improprio del concetto di dubbio. Nel linguaggio scientifico, il dubbio non è sinonimo di paralisi o relativismo.

Il dubbio scientifico serve a:

  • migliorare i modelli,
  • individuare limiti,
  • integrare nuovi dati.

Non serve a rinviare indefinitamente ogni decisione in attesa di una verità finale e immutabile. In contesti reali, non decidere è comunque una scelta, con conseguenze misurabili.

Il fatto che la scienza evolva nel tempo non implica che “tutto sia ugualmente vero” in ogni momento. Implica, piuttosto, che le decisioni vengono prese con le migliori conoscenze disponibili in quel momento, sapendo che potranno essere aggiornate.

Quando il metodo scientifico viene trattato come ideologia

Nel botta e risposta riportato in Figura 1 compare anche un altro fraintendimento tipico: l’idea che difendere il metodo scientifico significhi trasformarlo in una sorta di religione laica, intollerante al dissenso.

In realtà accade spesso l’opposto:

chi riduce la scienza a un dogma finisce per trattarla come un’ideologia, mentre chi la riduce a una semplice opinione finisce per svuotarla di significato.

Il metodo scientifico non è né una fede né un’opinione. È uno strumento critico, fallibile e autocorrettivo. Ed è proprio questa sua natura a renderlo affidabile.

Perché questo caso è esemplare

Lo scambio riportato non è un’eccezione. È rappresentativo di un modo molto diffuso di discutere di scienza nello spazio pubblico, in cui:

  • il metodo scientifico viene confuso con le sue applicazioni normative;
  • il dubbio viene usato come scudo retorico, non come strumento di analisi;
  • l’evoluzione delle conoscenze viene interpretata come prova di arbitrarietà.

Analizzare casi concreti come questo è utile non per “avere ragione”, ma per chiarire dove avviene lo slittamento concettuale.

Conclusione

Dire “lo dice la scienza” è una scorciatoia comunicativa che finisce per alimentare proprio i fraintendimenti che vorrebbe evitare. La scienza non parla, non impone e non promette certezze assolute. Fornisce strumenti per comprendere la realtà e basi razionali su cui costruire decisioni collettive.

Confondere questi piani non rafforza la scienza: la indebolisce.

Ed è solo mantenendo chiaro il confine fra metodo scientifico e decisioni normative che il dibattito pubblico può tornare ad essere, davvero, razionale.

Glühwein ad Amburgo: la chimica del vin brulé

Ed eccoci ad Amburgo. Fa freddo: oggi -5 °C. Finalmente un inverno vero, di quelli che a Palermo si studiano solo sui libri o nei film di Natale doppiati male.

Per il palermitano medio, 9–10 °C sono già “buriana siberiana”: scatta il piumino artico, il cappello da spedizione e l’espressione tragica da sopravvissuto.

Io vengo dalle montagne dell’avellinese e mia moglie è veneta: per noi “inverno” significa freddo, neve, focolare acceso, patate al cartoccio e la nobile arte del sonnecchiare in poltrona senza sudare. Qui l’aria del Natale è quella della mia infanzia: profumo di legna, musica ovunque, persone che sorridono davvero.

E poi c’è la viabilità, che è un’esperienza quasi mistica: la gente ti saluta anche se non ti conosce e, udite udite, in auto si ferma ai semafori. Non “rallenta per vedere se passa lo stesso”: si ferma proprio. E quando attraversi sulle strisce… ti lasciano attraversare. Una roba talmente surreale che per un attimo ho cercato la telecamera nascosta.

Amburgo è una grande città con mercatini dove trovi di tutto. Ma è un “tutto” di un kitsch feroce: talmente kitsch da andare oltre la bellezza. Ed è in questi mercatini – malamente copiati a Palermo, dove hanno perso il senso del Natale perché sono diventati stanziali, cioè stanno lì tutto l’anno come un arredo urbano – che accade qualcosa di magnifico: cammini, hai le mani congelate, il vento dell’Elba ti ricorda che esiste la termodinamica… e poi qualcuno ti mette in mano un bicchiere fumante di Glühwein.

A quel punto, in modo del tutto irrazionale, il mondo diventa più semplice.

Eppure, dentro quel bicchiere non c’è magia. C’è chimica fisica applicata, fatta bene o fatta male. E la differenza la senti subito: un Glühwein buono profuma, scalda, “abbraccia”; uno cattivo sa di marmellata bruciata con retrogusto da farmacia.

Il punto è uno solo:

Il Glühwein non deve bollire. Mai.

Non è snobismo: è fisica.

1) Se bolle, perdi quello che vuoi (e ti resta quello che non vuoi)

  • Gli aromi sono in gran parte molecole volatili: se fai bollire, le regali all’atmosfera.
  • Anche l’etanolo è volatile: a ebollizione lo perdi in fretta e ti resta una bevanda più piatta (e spesso più dolce e “pesante”, perché ti viene spontaneo compensare con zucchero).

Risultato tipico: odore da mercatino = ottimo, sapore nel bicchiere = bleah.

2) Temperatura = telecomando del profumo

Il profumo che senti è una questione di pressione di vapore: più scaldi, più certe molecole “scappano” in aria.

Ma non tutte scappano allo stesso modo: alcune spariscono presto (note fresche), altre restano (note “scure”, resinose, legnose).

Se esageri con la temperatura ottieni il classico effetto:

  • spariscono le note agrumate e “vive”
  • restano spezia pesante + zucchero + vino stanco

Quindi il Glühwein migliore è quello che sta in equilibrio tra “si sente” e “non evapora via”.

Zona felice: circa 70–80 °C (fumante sì, bollente no).

Le spezie non sono spezie: sono una miscela di VOCs

Il mercatino di Natale profuma perché le spezie liberano molecole aromatiche (molte sono VOCs, composti organici volatili):

  • Cannella: cinnamaldeide (nota calda, dolce, “da forno”)
  • Chiodi di garofano: eugenolo (potentissimo: basta poco)
  • Anice stellato: anetolo (liquirizia elegante o invasiva, dipende da dose)
  • Scorza d’arancia: terpeni tipo limonene (fresco, “luminoso”)

La cosa divertente è che il Glühwein è un solvente misto (acqua + etanolo): perfetto per estrarre un po’ di tutto.

E qui nasce l’errore più comune.

Errore da mercatino: “più spezie = più Natale”

No: più spezie = più rischio di sovra-estrazione e amarezza.

  • Chiodi di garofano: sono i “dominatori”. Se esageri, non senti altro.
  • Scorza di agrumi: ok, ma evita troppo bianco (albedo): lì vive l’amaro.

Zucchero: non serve a “dolcificare”, serve a cambiare la percezione

Lo zucchero nel Glühwein fa una cosa interessante: smussa acidità e astringenza (tannini), e rende il sorso “più rotondo”.

Ma se esageri, ottieni un effetto collaterale: copri gli aromi e ti sembra tutto uguale.

Trucco semplice: aggiungi zucchero alla fine, assaggiando.

Perché la dolcezza “sale” con il calore: a caldo sembra meno dolce, a temperatura un filo più bassa sembra molto più dolce.

Il “protocollo Amburgo” per un Glühwein buono a casa (senza laboratorio)

Regola d’oro

Scalda fino a fumante, poi stop. Niente bollore.

Mini-ricetta (1 bottiglia)

  • 1 bottiglia di vino rosso (non serve un top, ma evita quelli “morti”)
  • 1 arancia (solo scorza, poco bianco)
  • 1–2 stecche cannella
  • 2–4 chiodi di garofano (non di più se vuoi sentire il vino)
  • 1 anice stellato (facoltativo)
  • zucchero/miele: a fine corsa, quanto basta

Metodo:

  1. scalda tutto a fuoco basso finché fuma
  2. spegni, copri, lascia in infusione 10–20 minuti
  3. assaggia e regola la dolcezza
  4. filtra e servi

Coprire non è un dettaglio “da nonna”: è un modo banale per ridurre la fuga dei volatili.

Mini esperimento da blog (divertente e vero)

Fai due tazze uguali:

  • Tazza A: Glühwein portato quasi a bollore (anche solo un minuto)
  • Tazza B: Glühwein fumante ma non bollito, tenuto coperto

Poi annusa e assaggia.

Scommessa: la tazza A “profuma” in cucina (perché hai profumato l’aria) ma sa meno nel bicchiere.

Chimica natalizia

Ad Amburgo ti vendono il Glühwein come comfort. In realtà è un piccolo capolavoro di equilibrio: se rispetti la volatilità, ti resta il Natale nel bicchiere. Se fai bollire, regali il Natale ai passanti.


Quando la combustione non è combustione

Del perché l’ATP non è energia e quali sono gli equivoci più diffusi sul metabolismo

Qualche tempo fa mi è capitato di scrivere una risposta un po’ “di getto” a un post di un qualche professionista che aveva super-semplificato concetti biochimici abbastanza complessi. Onestamente, non ricordo nemmeno più di cosa si parlasse. Rileggendo la mia risposta, che avevo scritto e conservato nelle note del mio iPad, mi è venuta voglia di riprendere alcuni concetti e scrivere un articolo per il blog. Questo perché l’equivoco è diffusissimo e riguarda due parole che usiamo con troppa disinvoltura: combustione ed energia.

Ogni tanto, nei commenti e nei post divulgativi, ricompare un’idea seducente perché è semplice: “nel corpo bruciamo zuccheri e grassi, quindi è combustione”. Il problema è che, presa alla lettera, questa metafora non chiarisce: confonde.

Nel nostro metabolismo non c’è nessuna fiamma. C’è invece una sequenza finissima di reazioni di ossidoriduzione mediate da enzimi, progettata per estrarre energia a piccoli passi, conservarne una parte e spenderla dove serve. È proprio questa regia molecolare – lenta, selettiva, controllata – a rendere possibile la vita.

Metabolismo ≠ combustione (anche se alla fine escono CO₂ e H₂O)

La combustione è, idealmente, una reazione rapida e poco controllata, che dissipa energia soprattutto come calore e luce. Il metabolismo aerobico fa l’opposto: smonta le molecole in modo ordinato e progressivo “raccogliendo” energia in intermedi chimici.

Il ciclo dell’acido citrico (o ciclo di Krebs), per esempio, non è una specie di fornace che “produce energia” nel senso comune. Il suo compito principale è generare carrier ridotti (NADH, FADH₂) e un equivalente di ATP (GTP/ATP) per giro: elettroni “ad alto potenziale”1 che verranno poi convertiti in ATP tramite la respirazione mitocondriale. In pratica, NADH e FADH₂ cedono elettroni alla catena di trasporto degli elettroni nella membrana mitocondriale interna; l’energia liberata pompa H⁺ creando un gradiente protonico, che l’ATP-sintasi (un enzima) usa per produrre ATP.

Per ogni acetil-CoA, il bilancio classico è:

  • 3 NADH
  • 1 FADH₂
  • 1 GTP (o ATP equivalente)
  • 2 CO₂

“Energia chimica”: la scorciatoia dei “legami” e la parola giusta

A questo punto arriva spesso un secondo equivoco: “l’energia è contenuta nei legami chimici”. È una scorciatoia linguistica che può funzionare in una spiegazione rapida, ma rischia di piantare in testa un’idea sbagliata: l’energia non è un contenuto nascosto nel singolo legame, pronto a uscire quando lo rompi. Rompere legami costa energia; formare legami libera energia. Quello che conta è la differenza complessiva tra reagenti e prodotti.

Se vogliamo dirla pulita (senza “chimichese” inutile): la grandezza che interessa davvero, quando parliamo di “energia spendibile”, è l’energia libera di Gibbs. È lì che sta il significato operativo di “questa reazione può trainarne un’altra”.

ATP: non “energia”, ma un “vettore” di energia libera

Qui sta il nodo: ATP è una molecola, non una forma di energia. Ciò che ha significato fisico è la variazione di energia libera associata alla sua idrolisi: in condizioni standard biochimiche (ΔG°′) per ATP → ADP + Pi è circa −30.5 kJ/mol (≈ −7.3 kcal/mol).

Detto senza slogan: la cellula usa ATP come intermedio operativo per accoppiare reazioni che liberano energia (ossidazioni metaboliche) a reazioni che ne richiedono (biosintesi, trasporto attivo, contrazione muscolare). ATP non “è” energia: è uno strumento chimico che permette all’energia libera di essere trasferita e spesa in modo controllato.

Calorie, Joule e “energia degli alimenti”: misura diretta o equivalente?

Il Joule (J) è l’unità SI dell’energia. La caloria è un’unità storica ancora comunissima: nella definizione termochimica 1 cal = 4.184 J.

In nutrizione, poi, la trappola è linguistica: la “Caloria” dei cibi (spesso con la C maiuscola) è in realtà una kilocaloria: 1 Cal = 1 kcal = 1000 cal.

Quando diciamo che un alimento “apporta energia”, spesso ci riferiamo a un valore ricavato (storicamente) dalla calorimetria a combustione: bruci il campione e misuri il calore prodotto. È un modo standardizzato e utile, ma va letto per quello che è: un valore equivalente, non la descrizione letterale di ciò che avviene nel corpo.

In questo senso, il meccanismo è simile a un’abitudine ben nota in chimica analitica e agronomia: quando in etichetta trovi il potassio espresso come K₂O, non significa che nel fertilizzante ci sia davvero ossido di potassio; significa che il contenuto è riportato come equivalente convenzionale. Allo stesso modo, il “potere calorico” è un modo coerente per comparare contenuti energetici, ma non autorizza a immaginare la fisiologia come una combustione “a fiamma”.

“Metabolismo lento”: una frase comoda, ma chimicamente vuota

Un inciso necessario, perché qui si inciampa spesso: “ho il metabolismo lento”. La frase è diffusissima, e non la usano solo i profani: la usano anche alcuni nutrizionisti. Il problema è che, sotto il profilo chimico, detta così non significa nulla. “Metabolismo” non è una singola reazione con una velocità, ma un insieme enorme di vie e processi; “lento” rispetto a quale variabile? Con quale unità? Con quale condizione iniziale?

Se vogliamo parlare in modo serio, dobbiamo dire cosa intendiamo davvero: di solito si sta parlando della spesa energetica (quanta energia l’organismo consuma per unità di tempo), cioè di un flusso misurabile. In quel caso non serve la metafora: si dice metabolismo basale (BMR) o spesa energetica a riposo (REE), e si ragiona su cosa la fa variare: massa magra, età, sesso, stato ormonale, temperatura corporea, attività del sistema nervoso simpatico, ecc. Ma chiamarlo “metabolismo lento” è un modo pigro di mettere un’etichetta a un risultato (consumo più basso del previsto) senza dichiarare il parametro, la misura e il confronto.

In breve: “metabolismo lento” è una frase che suona scientifica, ma spesso è solo un modo per evitare la parte scientifica.

In pratica, cosa intendono davvero quando dicono “metabolismo lento”

Quasi sempre, dietro quella formula ci sono una (o più) di queste cose:

  • Metabolismo basale più basso del previsto (BMR/REE). Non perché le reazioni “vadano piano” in senso chimico, ma perché il “motore minimo” dell’organismo è proporzionato soprattutto alla massa metabolicamente attiva (in primis la massa magra) e a fattori fisiologici (età, ormoni tiroidei, stato infiammatorio, ecc.). Qui “lento” è solo un aggettivo messo al posto di un numero.
  • NEAT basso: il consumo che non si vede. C’è una quota enorme di dispendio energetico che non è “sport”: è movimento spontaneo, postura, gesticolazione, irrequietezza, camminate, scale, micro-attività quotidiane. Se questa quota cala, la persona “consuma meno” senza accorgersene. E il mito del metabolismo lento diventa il cappotto perfetto per coprire un cambiamento di comportamento.
  • Adattamento energetico durante diete restrittive. Quando l’introito calorico scende molto e a lungo, il corpo tende a ridurre alcuni consumi (anche tramite variazioni ormonali e riduzione di NEAT). Non è magia, non è “metabolismo che si rompe”: è fisiologia prevedibile. Chiamarlo “metabolismo lento” è un modo furbo per evitare la frase corretta: sto spendendo meno energia per unità di tempo rispetto a prima.
  • Confronti sbagliati e misure fantasiose. Molte “diagnosi” di metabolismo lento nascono da confronti senza metodo (tabelle generiche, smart-watch, stime grossolane, “calorie bruciate” sparate). Se il dato di partenza è rumoroso, la conclusione è narrativa.

“Metabolismo lento” è spesso un’etichetta che suona scientifica proprio perché non dice nulla di misurabile. Quando mancano parametri e unità, il linguaggio riempie il vuoto con metafore: ATP diventa “energia”, la respirazione cellulare diventa “combustione”. Ma così non si semplifica: si mescolano categorie diverse, e il risultato è un corto circuito linguistico che produce solo una cosa… altra confusione.

Semplificare sì, vendere fumo no

Semplificare è necessario. Ma esiste un punto preciso in cui la semplificazione smette di essere didattica e diventa errore travestito da chiarezza: quando parole grandi (“energia”, “combustione”, “umiltà”, “scienza”) vengono usate come scenografia, al posto dei concetti che fanno davvero funzionare la spiegazione (redox, ΔG, unità di misura, condizioni standard vs condizioni cellulari).

E qui la faccio secca: se uno scambia ATP per “energia”, non sta semplificando, sta sbagliando oggetto grammaticale e oggetto scientifico nello stesso colpo. È come discutere di temperatura e confondere il termometro con i gradi: poi puoi anche metterci sopra parole solenni, ma resta un errore di base.

L’umiltà scientifica non è dire “parliamo semplice” e poi pretendere che la realtà si adatti alla frase. È accettare che la realtà sia più strutturata, e che le metafore, quando diventano troppo comode, non illuminano: addormentano.

In breve: la divulgazione non deve essere un caminetto acceso. Deve essere una lente pulita. E quando la lente è sporca di slogan, l’unica cosa che si vede bene è lo slogan.

Glossario degli acronimi

BMR – Basal Metabolic Rate (o metabolismo basale). Rappresenta la spesa energetica minima necessaria a mantenere le funzioni vitali a riposo.

NEAT – Non-Exercise Activity Thermogenesis. È il dispendio energetico dovuto ad attività non sportive (movimento spontaneo, postura, ecc.).

REE – Resting Energy Expenditure (o spesa energetica a riposo). Rappresenta la spesa energetica a riposo, spesso usata in clinica/nutrizione.

SI – Sistema internazionale

Sigle e simboli

ADP – Adenosine diphosphate (adenosina difosfato). Prodotto dell’idrolisi dell’ATP.

ATP – Adenosine triphosphate (adenosina trifosfato). Molecola “intermedia” usata per trasferire energia libera tra reazioni.

CO₂ – Anidride carbonica. Prodotto finale dell’ossidazione completa del carbonio organico nel metabolismo aerobico.

FADH₂ – Flavin adenine dinucleotide (forma ridotta). Trasportatore di elettroni/protoni prodotto in alcune tappe metaboliche.

GTP – Guanosine triphosphate (guanosina trifosfato). Nucleotide energetico “equivalente” all’ATP in alcune reazioni.

NADH – Nicotinamide adenine dinucleotide (forma ridotta). Trasportatore di elettroni/protoni prodotto da molte ossidazioni metaboliche.

Pi – Inorganic phosphate (fosfato inorganico). Prodotto dell’idrolisi dell’ATP insieme ad ADP.

Note

1 ↩︎ Quando dico che NADH e FADH₂ “portano elettroni ad alto potenziale”, non intendo un misterioso superpotere degli elettroni. È un modo compatto per dire questo: quegli elettroni sono in una condizione energetica tale da poter “scendere di livello”, passando a un accettore più “affamato” di elettroni (come l’ossigeno), e in quella discesa liberano energia utilizzabile.

In termini più rigorosi, “alto potenziale” significa che la coppia redox (per esempio NADH/NAD⁺) ha una forte tendenza a donare elettroni a coppie redox con potenziale più alto (più ossidanti). La catena respiratoria non fa altro che gestire questa discesa a tappe: ogni trasferimento libera un po’ di energia, e quella energia viene usata per pompare H⁺ e costruire il gradiente protonico che alimenta l’ATP-sintasi.

Usando un’immagine mentale: non è una “combustione”, è più simile a una centrale idroelettrica. Gli elettroni sono l’acqua in quota: non “sono energia”, ma hanno la possibilità di cadere e far funzionare una turbina (qui: pompaggio di H⁺ e sintesi di ATP).

Share